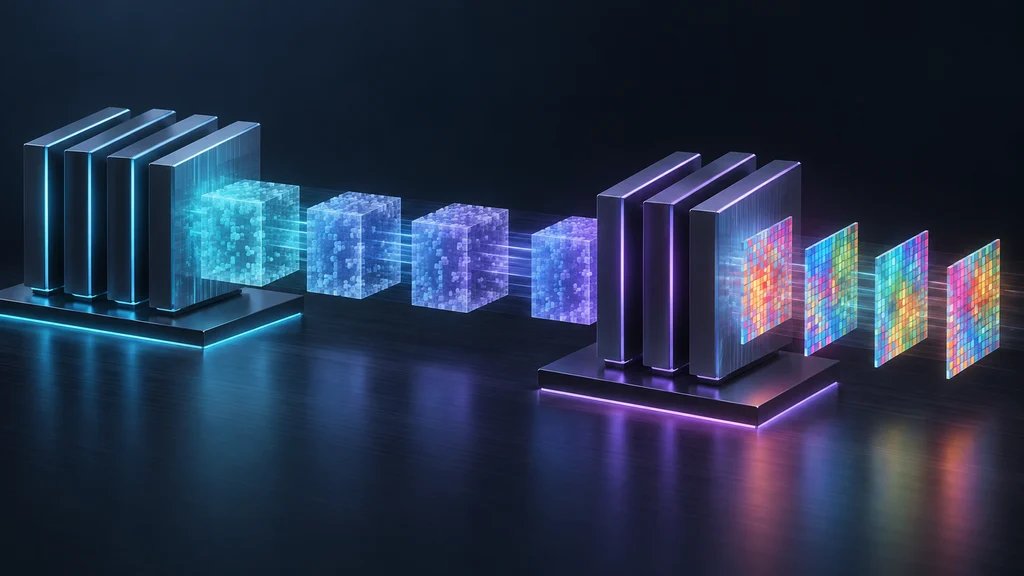
ストリーミング拡散動画生成のDiTとVAEを別々のGPUプールへ分離し、処理を重ね合わせる構成が実装された。Intelの測定では、同じGPU数の一体構成よりスループットが最大28%高かった。
潜在表現の生成と画素復号を別GPUプールへ
ストリーミング拡散動画生成の処理は、潜在表現を作る段階と、表示可能な画素へ戻す段階に分けられた。Intelの実装は、diffusion transformer(DiT)とvariational autoencoder(VAE)デコーダーを、Intel® Arc™ Pro B70 Graphics GPUs上の別々のGPUプールへ配置している。
DiTは圧縮された動画表現である潜在表現を生成し、その出力をVAEがRGBフレームへ変換する。テキストの符号化はDiT側に残し、H.264の動画符号化には既存のB70 GPUが備えるメディアエンジンを使うため、分離境界は潜在表現の生成と画素復号の間に置かれる。
潜在ブロックを1ステップずつ生成して直ちに復号
Causal Forcingは、複数回の双方向デノイジングを行う動画拡散モデルを、過去に生成した内容だけを参照する自己回帰型の生徒モデルへ蒸留する。この変更により、将来の潜在ブロックを待たずに、動画をブロック単位で生成できる。
蒸留後のDiTは各潜在ブロックを1ステップで生成し、VAEは受け取ったブロックを直ちにRGBフレームへ復号する。DiTとVAEの受け渡しが継続的に発生するため、DiTがブロックN+1を生成している間に、VAEがブロックNを復号するパイプラインを構成できる。
遅いVAEだけを空間シャーディングで増強
Intelのプロファイリングでは、このストリーミング処理で遅い段階はVAEによる復号だった。VAE側へ追加のGPUを割り当てると、DiT側の規模を変えずに、復号速度を潜在表現の生成速度へ近づけられる。
VAEの空間シャーディングは、潜在表現を高さ方向に分割して複数のGPUで処理し、畳み込みに必要な境界行をGPU間で交換する。報告された構成ではDiTだけで32GBのB70 GPUのうち約25.9GBを使うため、VAEとその活性化データを別のGPUへ移すことで、キャッシュや符号化バッファなどの実行時割り当てに使えるメモリーの余地も増える。
同一GPU数の比較でスループットが14〜28%向上
性能評価にはCausal Forcing Wan 2.1-1.3B T2Vを使い、832×480画素、243フレーム、3シーンの動画を生成した。集約構成と分離構成でB70 GPUの総数を同じにすることで、ハードウェア追加ではなく処理段階の分離と資源配分による差を測っている。
Intelの測定では、2基のGPUをDiT用とVAE用に1基ずつ分けた構成が、最良の集約構成をスループットで14%上回った。4基ではDiT用1基、VAE用3基とした構成が最良の集約構成を28%上回り、復号側への重点配分が最大の差を生んだ。
パイプラインが安定すると、連続する出力の間隔は転送と同期の負担を除いて遅い側の処理時間へ近づく。一方、この重ね合わせは最初の出力までに必要な処理の依存関係を取り除くものではない。