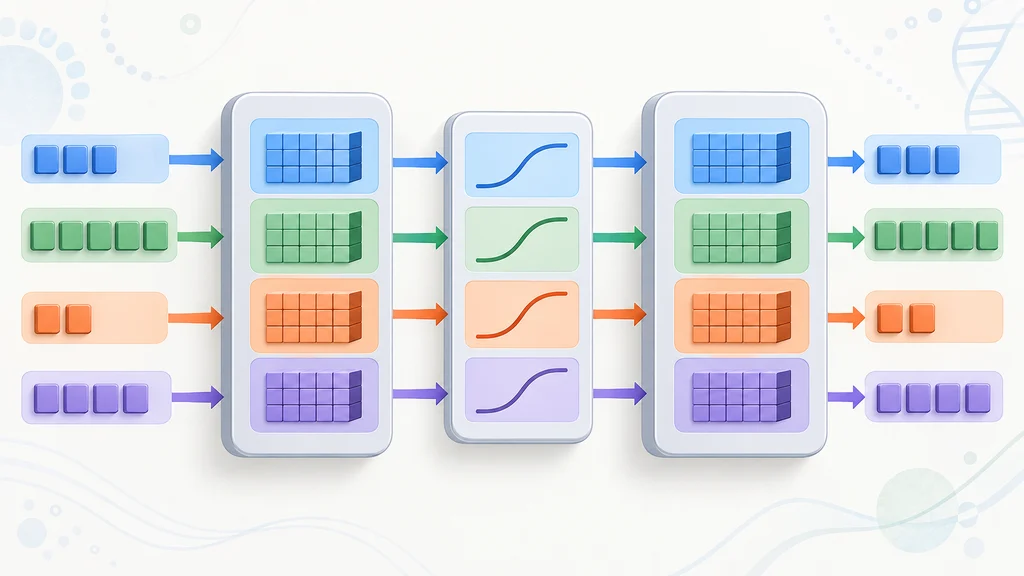
MoEモデルの学習で、Expertごとに分かれていた演算をまとめ、低精度計算と演算融合につなぐレシピが示された。NVIDIAの8基のB200による測定では、Hugging Faceの基準実装に対して最大2.21倍の処理量となった。
トークンごとに使うExpertを絞る
Mixture of Experts(MoE)は、トークンごとに複数のExpertから一部を選び、その部分だけを動かす。NVIDIAが示した生物学向けモデルの学習レシピは、この選択後に生じるExpertごとの演算を効率よく実行する構成を扱う。
Expertの線形演算を一度に投入する
比較対象のHugging Face実装は、ExpertをPythonのループで順に処理する。NVIDIA Transformer EngineのGroupedLinearは各Expertの重みを保ちながら、複数の線形演算を一つのGrouped GEMM経路へ投入する。
選ばれるトークン数はExpertごとに異なるため、GroupedLinearはそれぞれの入力数をsplit_sizesとして受け取る。これにより、Expertごとに演算を呼び出す構成を、まとめて投入する構成へ変える。
MXFP8で学習時の値を8ビットで扱う
BioNeMoの学習レシピは、重みと活性値を16ビットで表すBF16に加えて、8ビットで表すMXFP8をサポートする。MXFP8は連続する32個の値ごとにスケール係数を割り当てる方式で、NVIDIA Blackwell GPUでは専用のTensor Core命令を利用できる。
低精度演算の前後も融合する
低精度の演算には、値をMXFP8へ変換し、計算結果を高精度の形式へ戻す処理が伴う。Transformer EngineのSequential APIは、GroupedLinear、ScaledSwiGLU、GroupedLinearの並びを検出し、量子化、活性化、ルーティング重みの適用などを含む融合演算へ置き換える。中間結果の一部を別々に生成する処理も避けられる。
8基のB200で学習処理量を比較
NVIDIAが8基のB200 GPUで実施した学習ベンチマークでは、このBioNeMoレシピの処理量はHugging Faceの基準実装に対して最大2.21倍だった。この数値は、GroupedLinearだけの効果ではなく、レシピに含まれる複数の最適化を組み合わせた測定結果である。