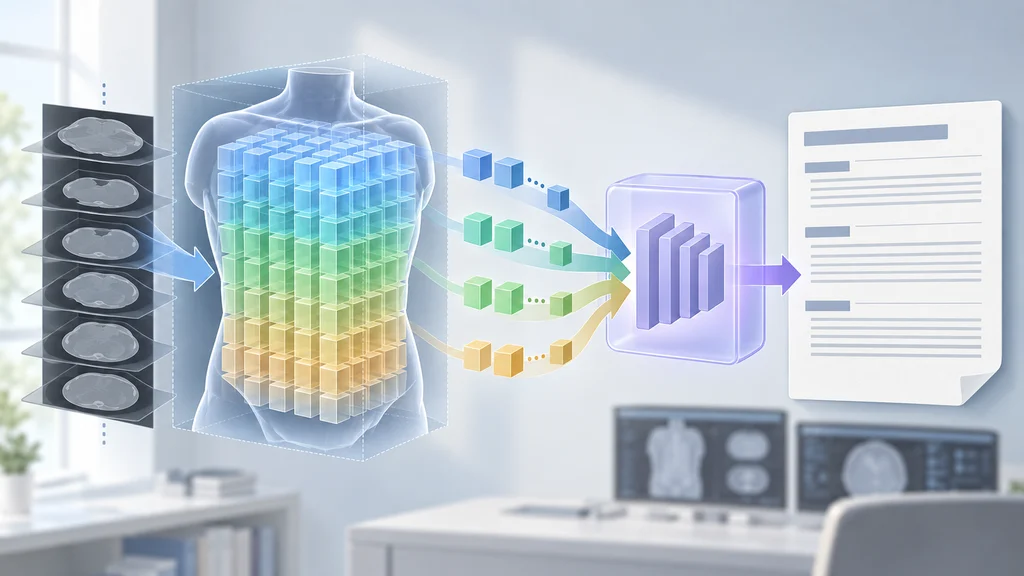
胸部・腹部CTを3次元のまま処理する視覚言語モデル「NV-Reason-CT」が公開された。断層間の位置関係を保った情報を言語モデルへ渡し、構造化レポートの生成や所見についての対話に使う研究開発用モデルだ。
CTの断層を立体データとして読み込む
NVIDIAの視覚言語モデルNV-Reason-CTは、胸部と腹部のCTを3次元の入力として扱う。画像を読み取る部分には、Primusを基にColipriの重みで初期化した3次元Vision Transformerを使い、その出力をQwen3.5-4B言語モデルへつなぐ。
入力時には対象を胸部か腹部に切り出し、各方向2mmの等方解像度で192×192×192ボクセルにそろえる。この前処理によって、立体的な範囲を後続のエンコーダーへ渡す。
1万3824個の区画と位置情報を言語モデルへ渡す
3次元エンコーダーは、前処理したCTを8×8×8ボクセルずつの重ならない区画に分ける。区画は縦・横・奥行きに各24個並び、計1万3824個の視覚トークンになる。
このモデルはトークンを空間的に統合・間引きせず、3次元座標とともに言語モデルへ渡す。言語モデル内の3D MRoPEは奥行き・高さ・幅の位置関係を扱い、隣り合う断層にまたがる情報を文章生成に引き継ぐ。
構造化レポートと所見への追加質問に対応
言語モデルは、胸部または腹部のCTから構造化レポートを生成する。解剖学的領域を順に確認し、所見や不確実性を述べる推論文も出力するよう訓練されている。
レポートを出した後も、利用者は特定の所見について追加質問を重ねられる。対話を続ける際は、同じモデルを読み込んだまま会話履歴を渡す実装例が公開されている。
CTに基づく質問応答で推論文を学習
学習には教師ありファインチューニングとGroup Relative Policy Optimizationが使われた。NVIDIAのモデルカードによると、学習データには7万111件の異なるCTボリュームから作られた約55万件の構造化された質問応答例が含まれる。
この学習データには、標準化されたレポート、異常所見に焦点を当てた質問応答、複数ターンの対話、放射線科医による推論の記録が含まれる。画像の特徴を文章へ変える構成に、領域ごとの確認手順を学習させている。
推論と追加学習の実行例を公開
公開リポジトリには、CTを入力する推論のほか、教師ありファインチューニングとGroup Relative Policy Optimizationの実行例が用意されている。胸部と腹部を選んで構造化レポートを求める例や、所見について質問する例も確認できる。
NV-Reason-CTの位置付けは研究開発用のモデルである。NVIDIAは医療機器としての使用や、専門家による判断の代替を想定していない。