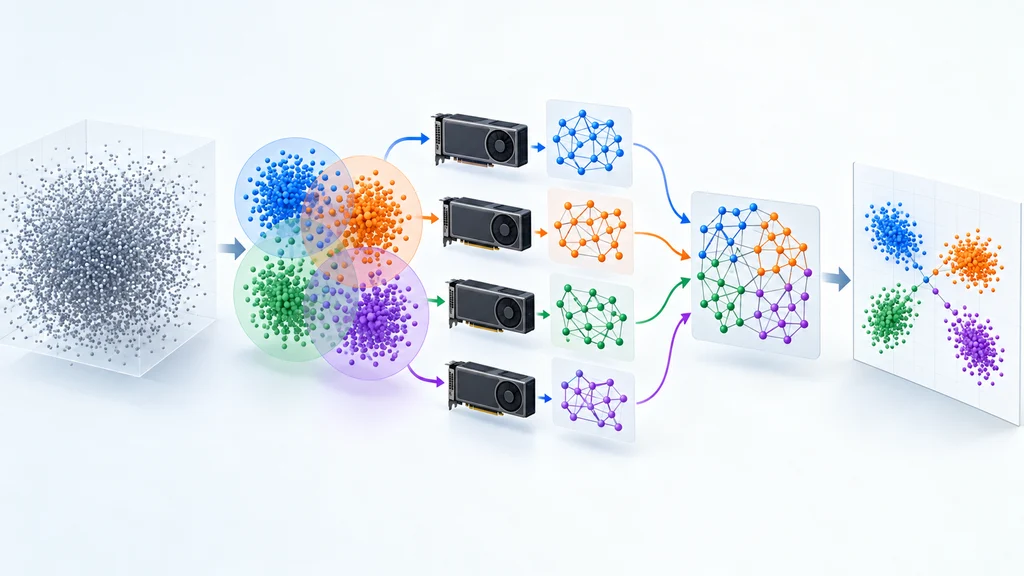
次元削減手法UMAPの学習で負荷の大きい近傍グラフ構築が、複数GPUへ分散された。NVIDIAの測定では、1億600万ベクトルの処理が8基のH100で8分で完了した。
学習を単一GPUにとどめていた近傍グラフ構築
GPU向け機械学習ライブラリcuMLの従来のUMAPでは、学習段階は単一GPUに限られ、複数GPUを使えたのは学習済みの変換を行うtransform()段階だった。NVIDIAはcuMLとGPU向けベクトル処理ライブラリcuVSの25.06で、学習に必要な全ベクトル近傍グラフの構築を複数GPUへ分散した。
このグラフは、データ内の各ベクトルについてk個の近傍ベクトルを求めて作る。対象が数千万から数億ベクトルに増えると、この工程の計算負荷が大きくなる。
重複するクラスタで境界の近傍を残す
入力ベクトルは、規模がほぼ等しい複数のクラスタへ分けられる。近いクラスタ間には同じベクトルを重複して割り当て、分割境界の両側にある近傍関係を拾えるようにする。
近傍グラフはクラスタごとに計算され、その結果が一つの全体グラフへ統合される。全データの近傍を一度に求める代わりに、分割した計算結果をUMAPの学習へ渡す構成だ。
各GPUが担当データを読み込み、局所グラフを計算
複数GPUへの分散では、各GPUが担当するクラスタのデータをCPUメモリから個別に読み込む。局所グラフの計算に全データを持つ必要がないため、クラスタをGPU間に割り当てられる。
クラスタごとの計算は独立して進み、GPU間の高コストな全対全通信を避けられる。得られた局所グラフは全体グラフへ統合され、分散計算の結果がUMAPの入力となる。
分割数と重複度がメモリと近傍の保持を左右
knn_n_clustersはデータを分けるクラスタ数を指定する。クラスタ数を増やすと、各クラスタに割り当てるベクトル数が減り、GPUごとに保持するデータ量を抑えられる。
knn_overlap_factorは各ベクトルを割り当てる近接クラスタの数を指定する。この値を増やすと境界をまたぐ真の近傍を残しやすくなる一方、各クラスタで処理するベクトルが増え、計算時間とメモリ使用量も増す。
この二つの設定はcuMLのUMAPからcuVSへ渡される。cuVSの全ベクトル近傍グラフ構築APIは、UMAPを介さず単独でも利用できる。
1億600万ベクトルを8分で処理
NVIDIAの測定では、MIRACLデータセットの1億600万ベクトルを対象にしたcuMLのUMAP処理が、8基のH100 GPUで8分で完了した。CPUとの速度比較は、同じ規模で測定したCPUの完走時間ではなく、小規模データの測定から推定した実行時間を基準とし、最大74倍だった。
GPUの使用数を変えた評価でも、近傍構造が低次元の配置にどれほど保たれるかを測るtrustworthinessのスコアは同程度だった。NVIDIAが示した結果では、GPU数を増やした場合も、この指標を大きく変えずに処理時間を短縮している。