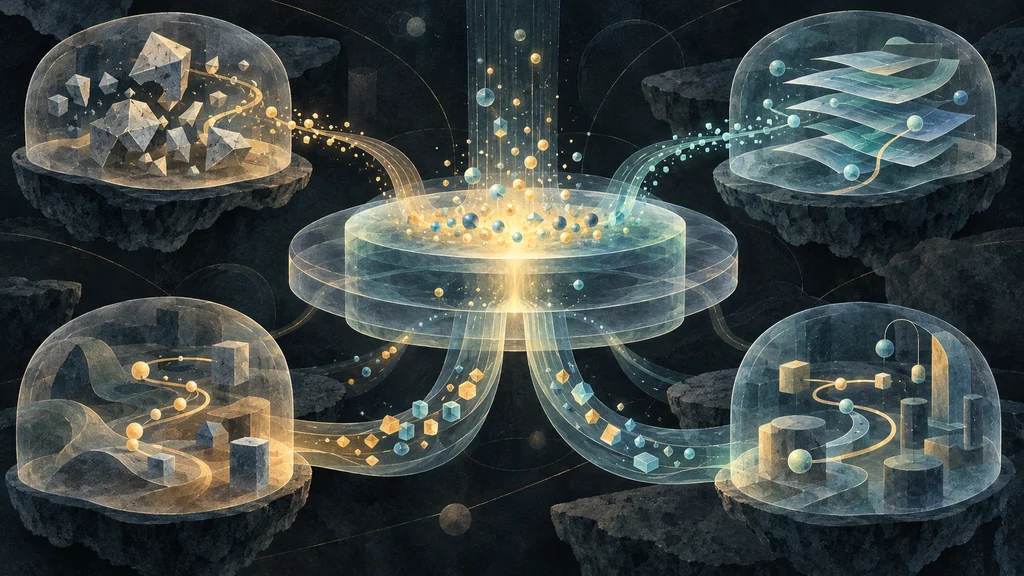
AIエージェントの実行環境を独立サービスへ分け、配備時と同じハーネス内で直接訓練できる共通基盤が公開された。隔離した実行領域をデータ収集、強化学習、評価で再利用する。
実行環境を訓練フレームワークから分離
オープンソースのAIエージェント向けフレームワークOrchardは、エージェントを動かす実行環境を特定の訓練フレームワークに埋め込まず、独立した再利用可能なサービスとして扱う。Microsoftは、専用サンドボックス、閉じた訓練パイプライン、独自データセットへの依存が、エージェント研究の利用と再現を妨げてきたとしている。
訓練アルゴリズムと実行環境を分けることで、新しいベンチマークやエージェントシステムを導入するときも、基盤全体を作り直さずに共通の環境層を利用できる設計とした。Orchardでは、この環境層を中核サービスのOrchard Envが担う。
数千の隔離領域をタスクと学習工程で共有
環境サービスのOrchard EnvはKubernetesを基盤とし、隔離されたコンポーネントを数千単位で並列に生成、管理、削除する。個々のエージェント試行を分離しながら、多数の実行領域を共通のサービスから制御する構成である。
このサービスは、ソフトウェア工学、Web閲覧、ツール利用など、性質の異なるタスクをサービス自体の変更なしで支えるよう設計されている。利用範囲もタスク実行に限らず、データ蒸留、強化学習のロールアウト、評価までを含む。
ハーネスのモデル呼び出しを訓練データへ変換
実際のAIエージェントは、モデル単体ではなく、複数ターンの推論、ツール利用、外部システムとの接続を管理するハーネスを介して動く。一般的なオープン訓練ツールでは、このような状態を持つ複数プロセスのハーネスを扱いにくく、訓練時の代替実装と配備時の実行経路に差が生じる。
Orchardでは、軽量プロキシがハーネス自身のモデル呼び出しを訓練データとして記録し、各ロールアウトを別々のコンテナで実行する。Microsoftによると、この処理により、Codex、OpenClaw、ZeroClawなどの配備用ハーネス内でエージェントをエンドツーエンドに訓練でき、複数のハーネスをまたぐ訓練にも対応するという。
三つの領域別レシピを同じ環境へ接続
共通環境の上には、ソフトウェア工学向けのOrchard-SWE、ブラウザー操作向けのOrchard-GUI、パーソナルアシスタント向けのOrchard-Clawという3種類の訓練レシピを接続する。タスクごとに訓練方法を変えながら、下層の実行環境を共有する構成である。
Orchardは、これらの訓練レシピだけでなく、モデル構築に使った訓練データと評価手法も公開対象に含める。環境、データ処理、評価の流れを領域間で再利用できる形にまとめている。
失敗した試行からも有効な判断を抽出
ソフトウェア工学向け訓練ワークフローOrchard-SWEは、MiniMax-M2.5とQwen3.5-397Bから蒸留した10万7000件のエージェント対話を使用した。対話はソフトウェア開発プラットフォームGitHub上のIssuesを対象とする。
credit-assignment supervised fine-tuningでは、課題を完全には解決できなかった試行も一律に捨てず、その中で生産的だった部分を訓練へ取り込む。続く強化学習ではBalanced Adaptive Rolloutを起点とし、強い教師モデルが判断を段階ごとに採点するon-policy distillationと、テスト作成や修正確認などの問題解決過程を評価するprocess reward modelを加える。
価値モデルが候補解を選び73.0%へ
Orchard-SWEは、強化学習で得た過去20件の実験のロールアウトを再利用し、40億パラメーターの価値モデルを訓練した。問題を解く段階では、この価値モデルが複数の候補解を採点して最良の候補を選ぶ。
Microsoftの測定では、SWE-bench Verifiedのスコアは61.4%のベースラインから、Balanced Adaptive Rolloutで69.1%、密な報酬手法の追加で69.7%になった。価値モデルで候補を再順位付けすると73.0%となり、訓練時に判断へ細かな信号を与える工程と、解答時に候補を選ぶ工程が別々の性能上昇に対応した。
ブラウザー操作でも共通環境を評価
ブラウザー操作向け訓練レシピOrchard-GUIは、400件の蒸留デモと2200件のオープンエンド訓練タスクを使い、40億パラメーターの視覚言語モデルを訓練した。自然言語で指定された作業に対し、視覚的なレイアウトを解釈して動的な画面を操作するエージェントを構成する。
Microsoftの測定では、Orchard-GUIはWebVoyagerで74.1%、Online-Mind2Webで67.0%、DeepShopで64.0%となり、3ベンチマークの平均は68.4%だった。コード修復とは入力も操作対象も異なるブラウザー操作で、同じ環境サービスに接続した別の訓練レシピが評価された。