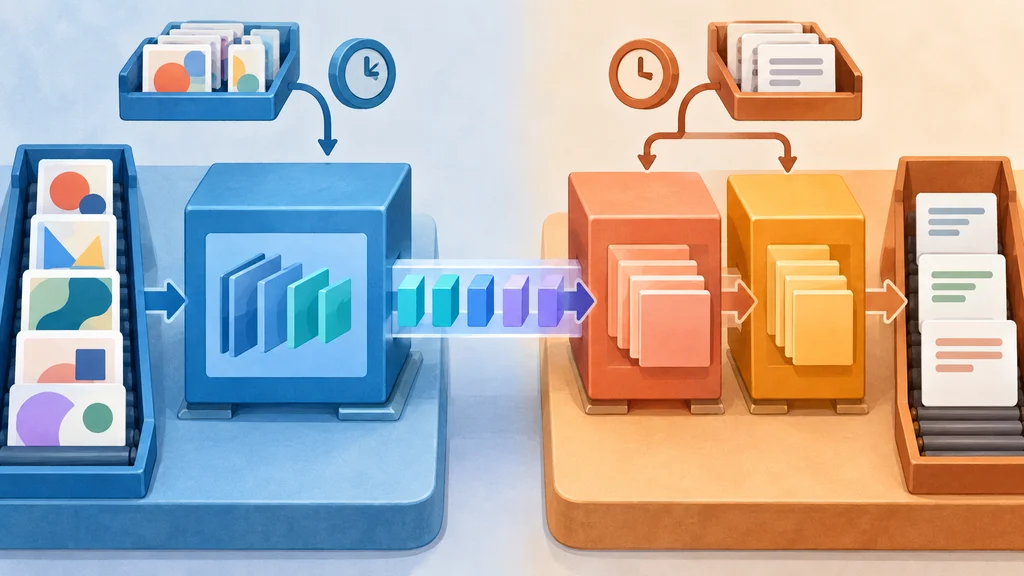
画像を扱うAI推論で、視覚エンコードを言語モデルの処理から分離する構成が実装された。NVIDIAの測定では、画像の多い入力など適した条件で、初回トークンまでの時間が一体型構成より最大5倍速かった。
画像から文章を作る前に生じる処理待ち
画像を含む要求は、言語モデルが入力を読み込むprefillに進む前に、メディアの前処理と視覚エンコードを通る。視覚モデルが作る埋め込み表現が、後続の言語モデル処理へ渡される。
一体型構成では、視覚エンコード、prefill、出力を順に生成するdecodeを同じワーカーのスケジューラーが扱う。画像や動画の多い要求では視覚エンコードに数百ミリ秒以上かかる場合があり、同じGPU上で進む言語モデルの処理とも計算資源を取り合う。
埋め込み表現を渡して処理段階を分離
NVIDIAの分散推論ソフトウェアDynamoは、視覚エンコード、prefill、decodeを分けるEPD構成を実装した。エンコード用ワーカーが生成した埋め込み表現は、転送ライブラリーのNIXLを介してprefill・decode用ワーカーへ届く。
両者を別のワーカーにすると、視覚エンコードと言語モデルの処理でバッチの組み方や実行順序を独立して決められる。要求量に応じたワーカーの台数調整も、処理段階ごとに行える。
同じGPUで分ける構成と別のGPU群へ置く構成
同居型のEPD構成では、エンコード用とprefill・decode用のワーカーが同じGPUを共有する。それぞれが別の要求待ち行列とバッチ処理を持つため、専用GPUを割り当てずに処理の管理を分けられる。
別置型では、視覚エンコードを低コストのGPU群に置き、埋め込み表現をNIXLで言語モデル用のGPU群へ転送する。NVIDIAの試験ではエンコードにRTX 6000Dを2基、prefill・decodeにGB200を4基使い、処理段階ごとに異なるGPUを割り当てた。
画像の多い入力で測定された応答時間
NVIDIAの測定では、画像の多い入力、短~中程度の出力、量子化したMixture of Experts(MoE)モデルに適した条件で、初回トークンまでの時間は一体型構成より最大5倍速かった。応答が完了するまでの時間も、最大7倍速いとしている。
この差は、視覚エンコードを言語モデルの処理から切り離した構成で得られた測定結果である。どちらの数値も特定の条件での最大値であり、すべての入力や出力長で得られる値ではない。
混在する要求とモデル精度で変わる効果
テキスト要求と画像要求を混ぜた試験では、平均初回トークン時間がテキスト要求で42.2%、画像要求で30.8%減少した。視覚エンコードを別の待ち行列へ移すことで、画像処理を必要としないテキスト要求も待たされにくくなる。
言語モデルの重みをNVFP4に量子化し、視覚エンコーダーをBF16に保った試験では、同じ応答目標を満たす処理量を示すgoodputが、同居型EPD構成で一体型構成比1.78倍から2.64倍へ上がった。一方、生成する文章が長くなりdecodeが処理時間の大部分を占めると、応答完了までの時間に対する改善幅は小さくなる。