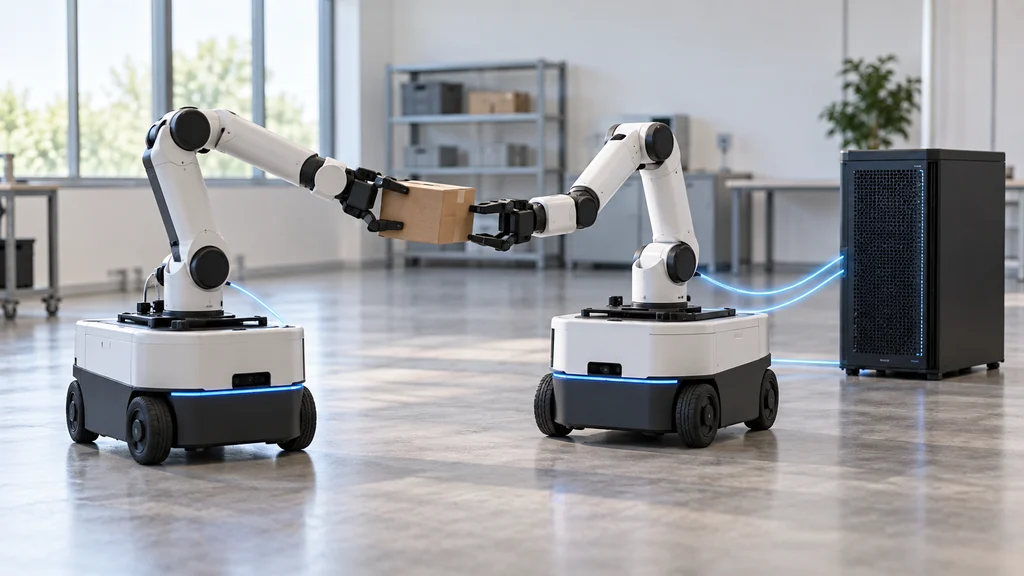
ロボットのAI推論を機体内のGPUから機外へ移すと、物体受け渡しの成功率が向上した。Microsoftは、移動と物体操作を伴う作業で推論の実行場所を比較し、軽量な機体内ハードウェアへの置き換えによる稼働時間の延長も報告した。
移動と物体操作を担う推論を機外へ移す
Microsoftは、移動しながら物を扱うロボットを対象に、AI推論をどこで実行するかを調べた。評価には、意味地図の作成と計画、移動、物体操作のモデルを含め、機体内、近くの計算設備、クラウドのGPUを使う構成を比較した。
一連の作業では、周囲を把握して移動経路を決め、目的の物を見つけて扱う。こうした処理を機体内だけで担う場合と、機外の計算設備へ送る場合の差が評価の対象になった。
小型GPUでは地図作成と障害物検出に差
評価した小型GPUの一部は、移動と物体操作に必要なモデル群を収容できなかった。十分なメモリーを持つGPUでも、意味地図の作成と計画の処理はA100との比較で最大383%遅くなった。
処理の遅れは、周囲の変化を移動に反映する段階にも現れた。軽量なGPUを使った移動モデルでは、障害物を適時に検出する性能が30%低下した。
物体操作の正確さと受け渡し成功率を比較
視覚情報と言語の指示から行動を決めるモデルでは、小型GPUでの処理の遅れに伴い、正確さが50%低下した。Microsoftの評価では、推論に使うGPUの違いが物体操作の結果にも表れた。
ロボットアーム同士で物を渡す作業では、推論を機外のGPUへ移した構成の成功率が向上した。移動や計画に加え、実際の受け渡し動作まで比較した結果である。
機体内GPUの置き換えで稼働時間を測る
稼働時間の比較では、機体内のGPUを軽量なRaspberry Pi-5基板に置き換え、推論用データを機外のGPUへ送った。この構成では、計算負荷の大きい推論を機体内で実行しない。
Microsoftは、この置き換えによってロボットの稼働時間が延びたと報告した。作業性能と電力消費の両面から、推論の実行場所を変えた効果を調べている。
コンテナを使って推論の配置を指定
Microsoftが構築したツール群は、指定したロボット向けAIの処理を自動的にコンテナ化し、機外へ移す。Kubernetesを使って、その処理をロボット、近くのGPU、クラウドの間に配置する。
開発時には、ロボット用シミュレーターに加え、ロボット学習用ツールのLeRobotやロボット向けソフトウェア基盤のROS2とも連携する。評価した機外推論の構成を、ロボット向け処理の配置に結び付けるツール群である。