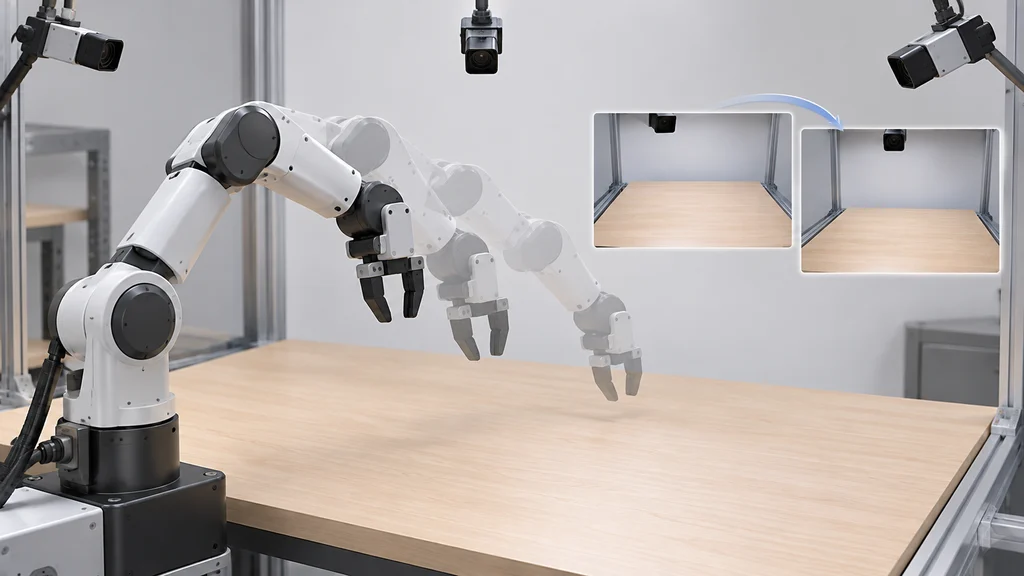
ロボットの動作だけでなく、その動作によってカメラの視界がどう変わるかも一つのAI方策で予測する。NVIDIAは動画の変化を学習した世界モデルCosmos 3をDROID向け方策へ追加学習し、動作軌道と将来の映像を生成する構成を示した。
動作生成の基盤を動画の世界モデルへ
従来のVision-Language-Action(VLA)方策は、事前学習した視覚・言語モデルに動作を生成する部分を加える。視覚情報と言語指示から行動を選ぶ一方、基盤モデル自体は場面がどう変化するかを予測するためのものではない。
World Action Model(WAM)は、動画の変化を予測する世界モデルを方策の基盤に用いる。NVIDIAが示したDROID向け方策もこの構成を採り、ロボットの動作と、その結果として見える場面を同じモデルで扱う。
テキストと動作を異なる生成処理につなぐ
基盤となる世界モデルCosmos 3は、Mixture-of-Transformers構成で出力の種類に応じて処理を分ける。自己回帰Transformerがテキストなどの離散トークンを順に生成し、拡散Transformerが映像や動作などを反復的なノイズ除去によって生成する。
NVIDIAによると、基盤モデルの学習データには約7億6700万枚の画像、約3億4800万本の実世界の動きを捉えた動画、約800万件の動作サンプルが含まれる。ロボット操作以外の動作データも含むこの基盤から、個別のロボット向け方策を追加学習する。
DROID向け方策が動作と予測映像を出力
NVIDIAはCosmos 3 Nanoから160億パラメータ、Cosmos 3 Edgeから40億パラメータのDROID向け方策を追加学習した。DROIDはFranka PandaアームとRobotiqグリッパーを使うロボットプラットフォームで、方策は言語指示と複数のカメラ観測から動作軌道を生成する。
この方策は動作列に加え、その動作を実行した場合にカメラが捉えると予測した映像も生成できる。将来の映像は実行結果の計測値ではなく、動作とともにモデルが生成する予測出力である。
同じ学習条件で成功率を比較
NVIDIAは、初期チェックポイントだけを変えたDROID方策を、同じ学習手順、データ、計算量で比較した。一方は基準モデルから、もう一方は複数領域の動作データで学習したチェックポイントから追加学習している。
この比較では、後者のRoboLabでの成功率は36.8%となり、基準モデルの28.1%を上回った。数値が示すのは、この評価条件で初期モデルの違いに伴って生じた成功率の差である。
大型モデルは外部計算機、小型モデルはロボット側で実行
160億パラメータの方策は、ロボットの外に置いた1基のNVIDIA RTX PRO 6000で運用された。ロボットが観測をネットワーク越しに送り、計算機が生成した動作列を受け取る。
NVIDIAによると、40億パラメータのEdge方策はJetson Thor上で640×360画素の観測を扱い、推論ごとに32個の動作を生成して15Hzの制御を達成した。同じ世界モデルを基盤とする方策について、外部計算機での実行とロボット側での実行が示されている。