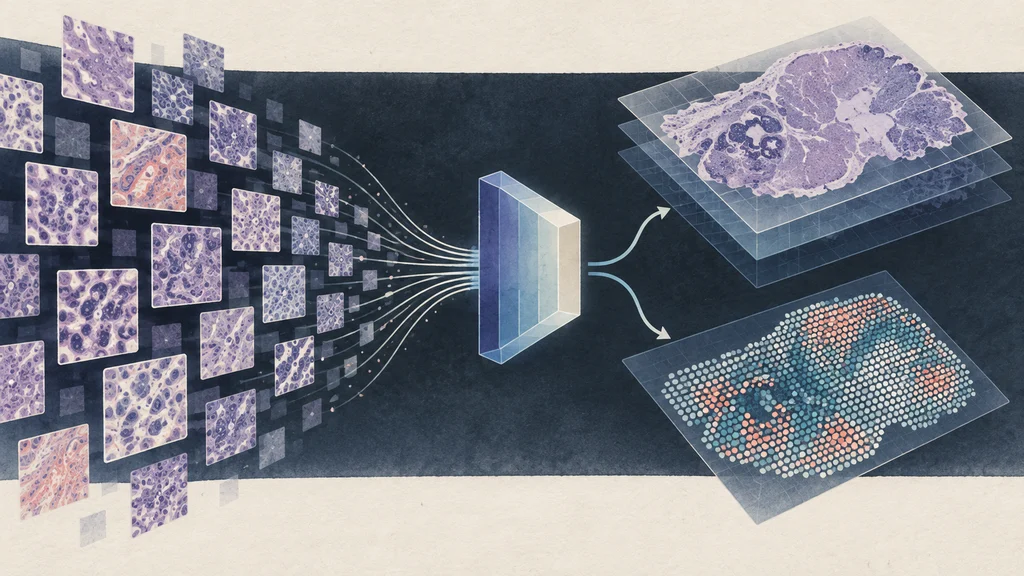
10億パラメーター規模の病理画像エンコーダーから小型のViT-Sを蒸留し、ホールスライド解析の予測性能を保ちながら計算量を減らす研究モデルが開発された。同じ画像基盤は、H&E画像から空間タンパク質を予測する処理も高速・省メモリ化する。
巨大な病理画像が反復解析の計算負荷を押し上げる
ホールスライド画像はしばしば1ギガピクセルを超え、基盤モデルで1枚を解析する場合にも数千の画像タイルを処理する必要がある。患者数が数万規模へ増えると、各タイルから特徴を抽出する処理量も積み上がる。
患者集団を対象とする研究では、特徴抽出に続いて、部分集団、バイオマーカー、臨床評価項目を変えながら統計解析、仮説検定、検証を繰り返す。Microsoftは、この計算コストが調査できる患者数、データセット、課題、仮説を制約するとして、反復利用する画像モデルの小型化に取り組んだ。
蒸留したViT-Sがタイルをスライド全体の表現へ変える
病理画像向け基盤モデルのGigaPath-Flashと空間プロテオミクス予測モデルのGigaTIME-Flashは、小型のViT-Sタイルエンコーダーを共通基盤に使う。このエンコーダーは、元の10億パラメーター規模のGigaPathエンコーダーを教師として蒸留され、大規模モデルが学習した病理画像の表現を小さなバックボーンへ移している。
ホールスライド表現学習を担うGigaPath-Flashは、2200万パラメーターのViT-Sタイルエンコーダーに、2100万パラメーターのLongNetスライドエンコーダーを接続する。前段が各タイルを埋め込みへ変換し、後段がスライド内の全タイルをdilated attentionで文脈化する。この後段処理はタイル数に対して線形に拡張する。
小型画像基盤から空間タンパク質を予測する
空間プロテオミクス予測モデルのGigaTIME-Flashは、元のGigaTIMEが使っていたCNNバックボーンをGigaPath-FlashのViT-Sエンコーダーへ置き換え、軽量な畳み込みデコーダーを接続する。エンコーダーが通常のH&E画像から病理特徴を抽出し、デコーダーがその出力を空間タンパク質の予測へ変換する。
調整にはLoRAアダプターを使い、事前学習済みエンコーダーの重みは大部分を固定する。この構成により、ホールスライド表現と空間プロテオミクス予測が、蒸留された小型の画像エンコーダーを共有する形になった。
分類性能とタンパク質予測を保ちながら計算資源を減らす
Microsoftの測定では、GigaPath-FlashはPANDA前立腺グレーディングとEBRAINS脳腫瘍サブタイピングで、元のGigaPathの予測性能の97%を約50分の1の計算量で達成した。蒸留したタイルエンコーダーと、全タイルを文脈化するスライドエンコーダーを組み合わせた場合の比較結果である。
空間タンパク質予測は、脳、乳房、結腸、肺のがんを含む分布内外のコホートで評価された。GigaTIME-Flashは全評価コホートで元のGigaTIMEと同等以上の予測品質を示し、効率比較では約6倍高速、メモリ使用量は約8分の1となった。
100万枚規模の処理時間を単一GPU条件で見積もる
Microsoftは、1枚当たり約1万タイル、バッチサイズ128、単一のNVIDIA A100 GPUという条件で、GigaTIME-Flashによる仮想mIF生成時間を推定した。所要時間は1000枚で約2 GPU時間、10万枚で約7 GPU日、100万枚で約70 GPU日となる。実際の時間はスライドサイズ、タイル化の解像度、ハードウェアによって変わる。
GigaPath-FlashとGigaTIME-Flashは、Apache 2.0ライセンスのopen-weightモデルとして公開され、モデル重みとコードがHuggingFaceで提供されている。いずれも研究モデルであり、診断、予後予測、治療選択などの臨床利用を意図したものではなく、それらの用途では検証されていない。