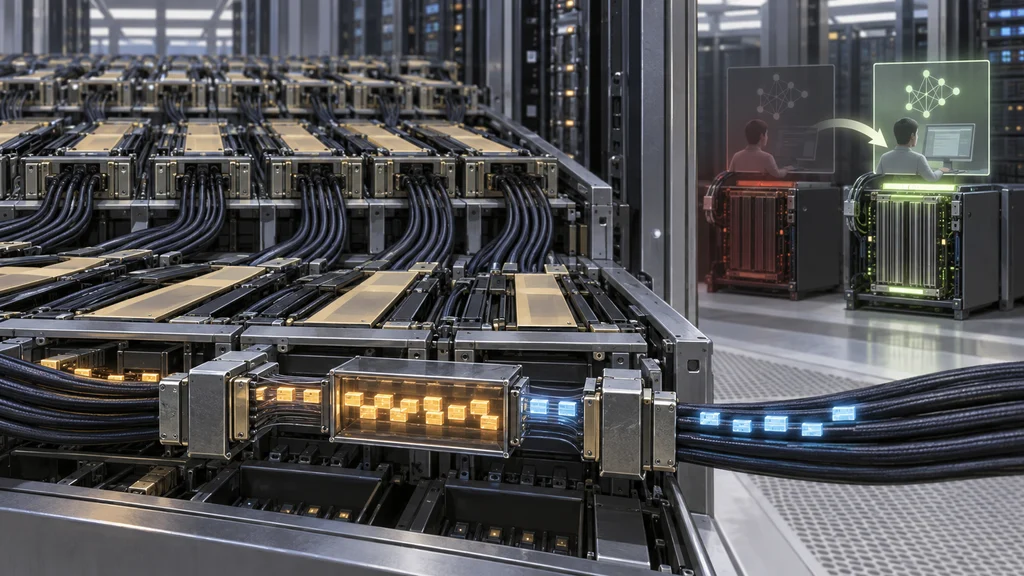
GPU間通信網のNVLink 6は、信号誤りの訂正と再送から、制御系の冗長化、推論プロセスの切り替えまでを組み合わせて障害に対処する。NVIDIAが示したB200 GPUでの比較では、推論能力の復旧時間がコールドリスタートの283秒に対し、複製プロセスへの切り替えでは7.3秒だった。
72基のGPUをつなぐ通信網に障害対策を重ねる
NVIDIAのラック型計算基盤Vera Rubin NVL72は、72基のRubin GPUをGPU間通信網NVLink 6で一つのスケールアップ領域に接続する。NVIDIAは、この通信網の物理層から推論ソフトウェアまでに障害対策を重ねた構成を示した。
通信経路で生じる信号誤りには、まず前方誤り訂正で対処する。訂正しきれない場合には物理層で再送し、リンク自体が切断されるほど劣化した場合にはUPHYによる復旧へ進む。
誤り訂正で復元できないパケットは物理層で再送する
前方誤り訂正では、送信ポートがデータに誤り訂正符号を付加する。受信側はその符号を使って破損したビットをインラインで復元し、通信を上位のソフトウェアへ戻さずに処理する。
誤りが訂正能力を超えた場合は、物理層でパケットを再送する。さらにリンクが切断された場合、UPHYが物理パラメーターを再調整する間、パケットをハードウェアの再送バッファーに保持する。
リンク層は輻輳によるパケット損失を抑える
信号誤りへの対処とは別に、リンク層はクレジットベースのフロー制御を使う。これは送信可能なデータ量を受信側の空き容量に応じて管理する仕組みで、NVIDIAは輻輳時のパケット損失を防ぐ設計だとしている。
物理層が破損したデータの訂正・再送を担い、リンク層がデータの送り過ぎを防ぐ。この役割分担によって、異なる原因で起きる通信上の問題にそれぞれ対処する。
制御系は複数の経路とスイッチで構成する
通信経路の対策に加え、システム構成には冗長化したスイッチトレイ、分散したNMX Controller、二重化した帯域外管理経路が含まれる。NVIDIAは、個別の構成要素に障害が起きても領域全体の運用を続けるための設計としている。
物理層とリンク層がデータの破損や損失に対処する一方、これらの冗長構成は通信網を管理する側の障害に備える。障害への対処を一つの機器や一つの処理だけに依存させない構成だ。
待機中の複製プロセスが推論能力を復旧する
通信障害が推論エンジンの停止に及ぶ場合には、推論ソフトウェアNVIDIA DynamoのShadow Engine Recoveryが事前に起動した複製プロセスへ切り替える。停止後に推論エンジンを一から起動する手順を避ける仕組みだ。
NVIDIAが示したB200 GPUでの比較では、この切り替えによる推論能力の復旧に7.3秒かかった。コールドリスタートの283秒と比べ、通信網だけで対処しきれない障害でも推論側の復旧時間を短縮した結果となっている。