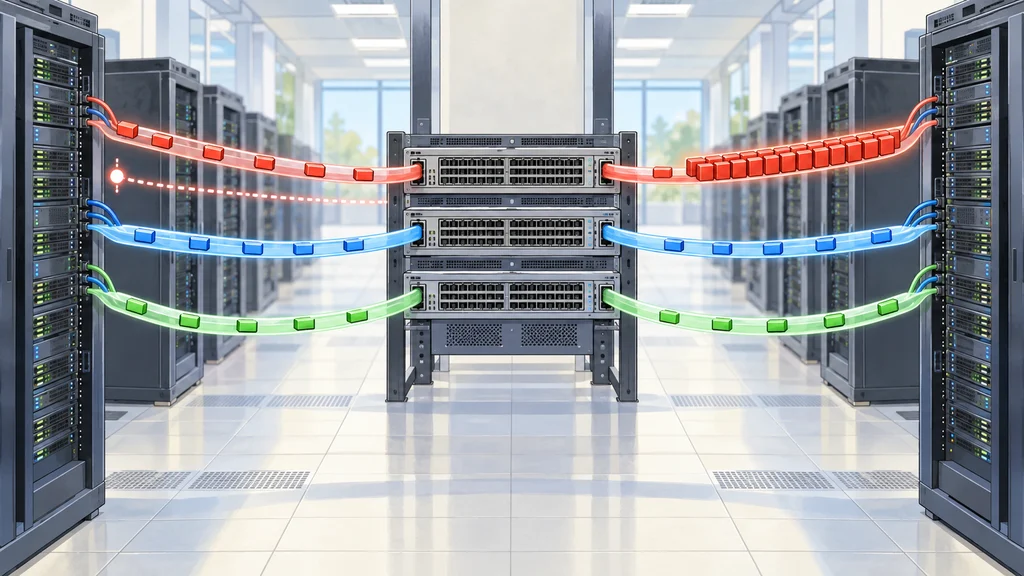
AI学習向けネットワーク「Spectrum-X Ethernet」は、混雑に応じたパケット経路の選択と送信速度の調整を組み合わせる。NVIDIAの模擬実験では、競合トラフィックを加えても学習1ステップの時間は668ミリ秒だった。
同期通信では一つの混雑経路が学習を遅らせる
大規模なAI学習では、GPU間で結果をそろえるAll-ReduceやAll-to-Allなどの同期通信が発生する。これらの通信は、比較的少数の大きなフローが同時に流れるため、一般的なデータセンター通信とは異なる負荷をネットワークにかける。
従来型EthernetのECMPは、フローから計算した値を使って経路を静的に割り振る。同じリンクに大きなフローが重なると、同期処理はその中で最も遅いフローの完了を待つことになる。
キュー長を見てパケットごとに出口を選ぶ
NVIDIAのAI学習向けネットワーク「Spectrum-X Ethernet」では、スイッチがECMPグループ内の各出力ポートのキュー長をマイクロ秒未満の間隔で調べる。この情報を使うAdaptive Routingは、到着したパケットごとに経路を選ぶ。
パケットは、その時点で最も混雑の少ない出力ポートへ送られる。NVIDIAは、この制御が局所的な混雑に数百ナノ秒で反応すると説明している。
受信先に集中する通信は送信速度も調整する
経路間の負荷を均しても、複数の送信元が一つの受信先へ同時にデータを送れば、受信先側で輻輳が起きる。Adaptive Routingだけでは、この通信の集中を解消できない。
Spectrum-X Ethernetでは、スイッチが経路選択で混雑をさばききれず、キューが増え続ける場合にECNで輻輳を知らせる。送信側は通信の往復時間を示すRTTの計測結果とECNを使い、送信速度を調整する。
競合トラフィック下で比べた学習ステップ時間
NVIDIAが示したDeepSeek-V3学習の模擬実験では、従来型Ethernetの学習1ステップの時間は単独実行時に735ミリ秒だった。競合トラフィックを加えると、1.18秒になった。
同じ模擬実験で、Spectrum-X Ethernetの学習1ステップの時間は単独実行時も競合トラフィックを加えた条件も668ミリ秒だった。これはNVIDIAが示した模擬実験での結果である。