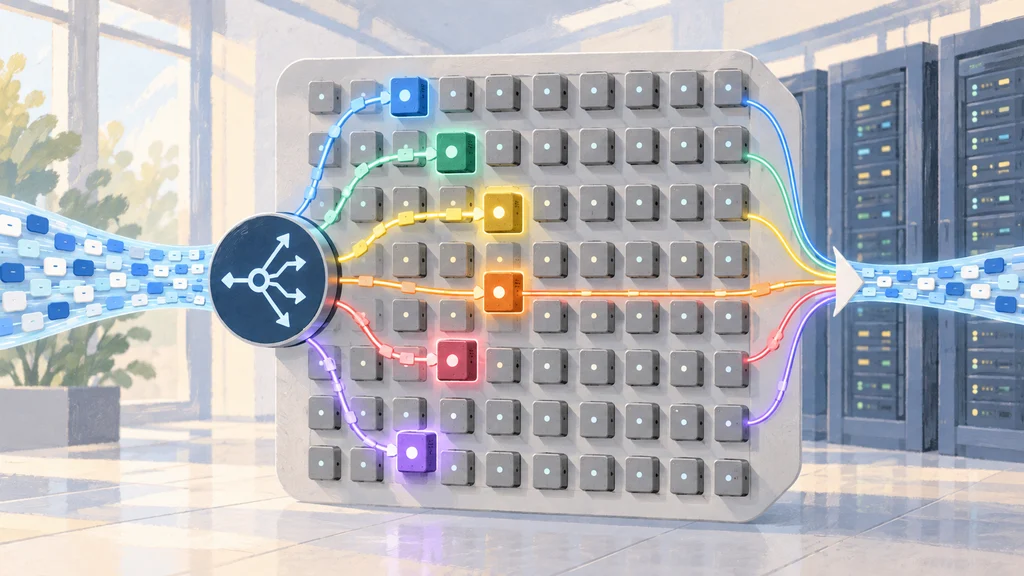
AIモデル「Nemotron 3 Nano」は、MambaとTransformerを組み合わせた構成に疎なMoEを導入し、処理時に稼働する部分を絞った。NVIDIAの単一H200での測定では、Qwen3-30B-A3Bの3.3倍の推論処理量を示した。
316億パラメータのうち処理時に使う部分を絞る
NVIDIAが公開したAIモデル「Nemotron 3 Nano」は、総パラメータ数が316億に達する。一方、1回の処理で稼働するのは埋め込みを除いて32億、埋め込みを含めて36億パラメータだ。
モデルの基盤にはMambaとTransformerを組み合わせた構成を使う。そこへMixture of Experts(MoE)を組み込み、全パラメータを毎回稼働させる構成とは異なる処理経路を取る。
MoEのルーターが128個から6個のExpertを選ぶ
Nemotron 3 Nanoでは、前世代の構成にあった標準的なFeed Forward Network層を疎なMoE層へ置き換えた。MoEのルーターは各処理で128個のExpertから6個を選び、選ばれた部分を稼働させる。
この選択によって、モデル全体のパラメータ数と1回の処理で稼働するパラメータ数が分かれる。316億という総数に対し、実際に稼働する部分は埋め込みを含めても36億パラメータとなる。
長い入力への対応と複数環境での後学習
Nemotron 3 Nanoのコンテキストウィンドウは最大100万トークンに対応する。NVIDIAは長いコンテキストへの対応を拡張するため、51万2000トークンと4000トークンの系列を混ぜた継続事前学習を行った。
後学習には、数学、コード、質問応答、複数段階のツール利用などを含む複数環境での強化学習も使われた。NVIDIAはモデル重みに加え、学習レシピと、再配布権を持つデータを公開した。
単一H200で比較モデルを上回った推論処理量
NVIDIAが単一のH200で入力8000トークン・出力1万6000トークンの条件を測定したところ、Nemotron 3 Nanoの推論処理量はQwen3-30B-A3Bの3.3倍だった。同じ条件でGPT-OSS-20Bと比べた推論処理量は2.2倍だった。
NVIDIAによると、前世代のNemotron 2 Nanoとの比較でも、1回の処理で稼働するパラメータを半分未満に減らしながら精度を上回った。この比較は、MoE層への変更に伴う稼働規模と精度の差を示している。