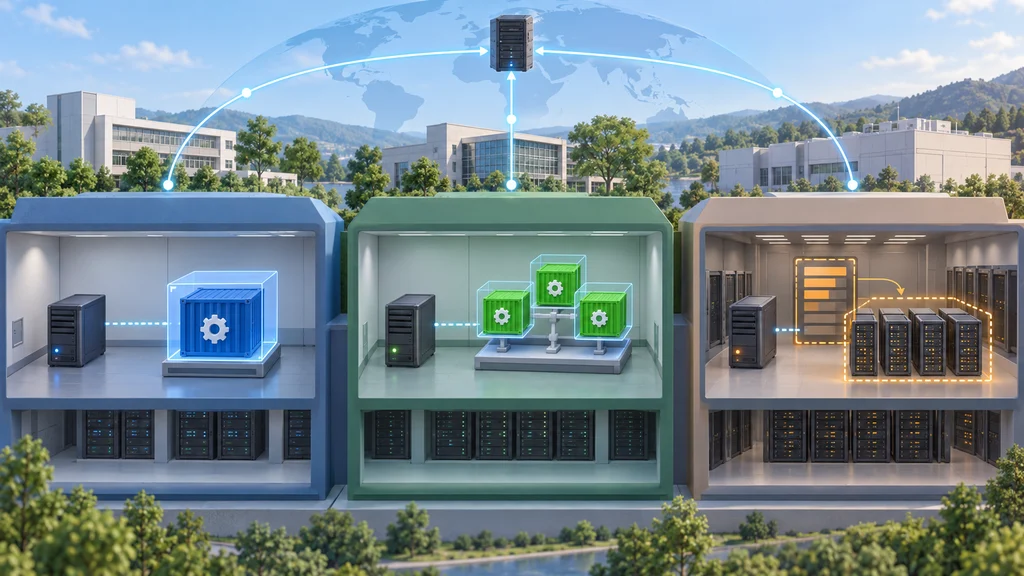
連合学習基盤NVIDIA FLARE 2.9がSlurmに対応した。常駐する連携処理とジョブの実行処理を分ける構成により、同じ連合学習に参加する拠点でDocker、Kubernetes、Slurmを使い分けられる。
連携を維持する親プロセスとジョブ用ワーカーを分離
NVIDIAの連合学習基盤NVIDIA FLAREでは、常駐するサーバーとクライアントの親プロセスが拠点間の接続、認証、作業の調整を担う。提出された学習ジョブは、親プロセスとは別に起動するサーバー・クライアントのワーカーで実行する。
親プロセスは学習用GPUを占有せずに稼働する。ジョブが投入されると各拠点の親プロセスがワーカーを起動し、ワーカーは処理結果を返して終了する。
資源要件を各拠点の実行単位へ変換
ジョブは必要なGPU、スケジュール可能なCPU単位、ホストメモリーを、実行環境の詳細と分けて指定できる。この指定を受けた各拠点の起動処理は、資源要件と拠点側の研究設定を組み合わせる。
起動処理は組み合わせた設定を、拠点に応じてDockerコンテナー、Kubernetesポッド、Slurmの資源割り当てへ変換する。NVIDIAによると、これにより同じ連合学習に参加する拠点が、それぞれ異なるジョブ実行環境を使用できる。
Slurm対応でバッチ実行を選択肢に追加
従来のNVIDIA FLARE 2.8は、DockerとKubernetesによる配備に対応していた。Dockerでは常駐する親コンテナーとは別にジョブ用コンテナーを起動し、Kubernetesでは親ポッドがジョブ用ポッドを作成して、スケジューラーが配置を決める。
NVIDIA FLARE 2.9にはSlurm対応が加わった。Slurmを使う拠点ではワーカーをバッチジョブとして投入し、Slurmが計算資源を割り当てる。
研究ごとに参加拠点とローカル資源を対応付け
複数の研究が同じ配備を使う場合、NVIDIA FLAREのstudyは参加するクライアント拠点と管理者を研究ごとに定める論理的な区分になる。ジョブを実行する拠点は、この区分に応じた設定を適用する。
各拠点の運用者はstudyごとに、使用するデータセット、秘密情報、承認済みイメージ、スケジューリング方針を拠点側で対応付けられる。連合学習の調整を共有しながら、ジョブに渡す資源と運用条件は各拠点が設定する。