AIエージェントが使うモデルを、要求の内容や作業の進み具合に応じて選ぶライブラリが公開された。NVIDIAのNeMo Switchyardは、複数モデルを組み合わせる処理に、新たに公開した軽量モデルも利用できる。
要求ごとに使用モデルを選ぶ
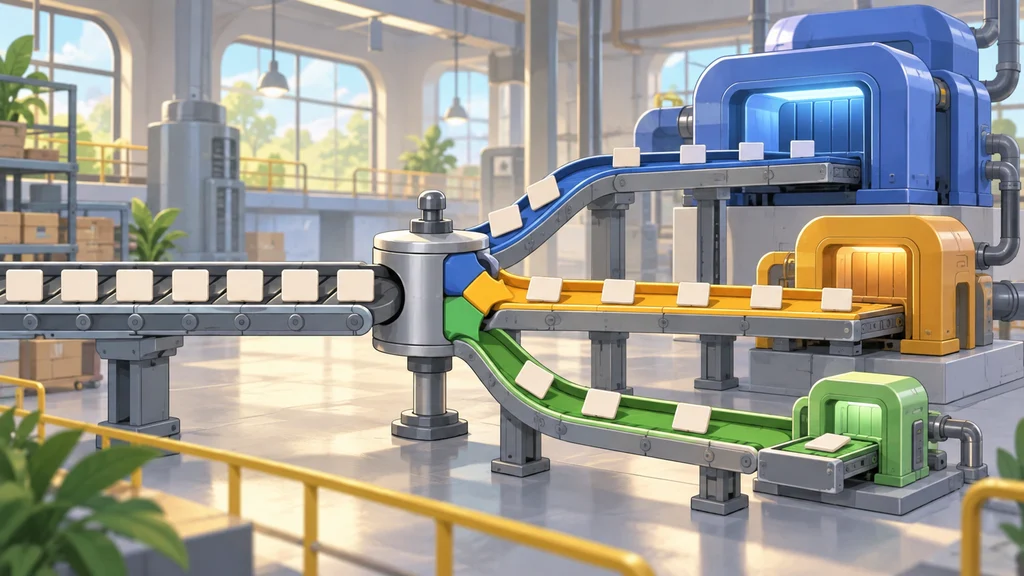
NVIDIAが公開したオープンソースのライブラリNeMo Switchyardは、AIエージェントから届く要求の振り分け先を決める。開発者はオープンモデル、独自モデル、NVIDIAのモデルを組み合わせ、各要求に使うモデルを選択できる。
この構成では、エージェント全体を一つのモデルに固定する必要がない。モデルの呼び出しと応答は、振り分け結果を受け取るアプリケーションやゲートウェイが担う。
要求と作業履歴から振り分け先を決める
振り分けを始めるには、アプリケーションで使用可能なモデル群とルーティングアルゴリズムを設定する。アルゴリズムは要求の内容、またはエージェントが直近に使ったツールの状況を調べ、次に使用するモデルを選ぶ。
選択は作業の開始時だけに限られない。エージェントが処理を続ける間も振り分け先を変えられるため、同じ作業の異なる段階で別のモデルを使う構成を取れる。
振り分け先に加わる軽量モデル
NVIDIAは、専門的な作業を担うAIエージェント向けモデルNemotron 3.5 Lightningも公開した。総パラメータ数は300億だが、計算時に稼働するのは30億で、Mixture of Experts(MoE)方式を採用している。
モデル内部ではMamba-2層とMoE層に、一部のAttention層を組み合わせる。NeMo Switchyardが選択できるモデル群に、この軽量モデルを含められる。
タスク完了費用と処理時間の評価
NVIDIAの社内ベンチマークでは、NeMo Switchyardによる振り分けは高性能モデル並みの精度を維持しながら、Opus 4.8だけを使う場合に比べてタスク完了費用を約3分の1に抑えた。これはモデルの呼び出し単価ではなく、作業を終えるまでの費用の比較である。
振り分け先となるNemotron 3.5 Lightningについても、NVIDIAは、同クラスの他モデルと比べてエージェントのタスク完了時間が30%短かったとしている。両者の評価はそれぞれ異なる比較であり、費用と時間を一つの測定結果として扱うものではない。