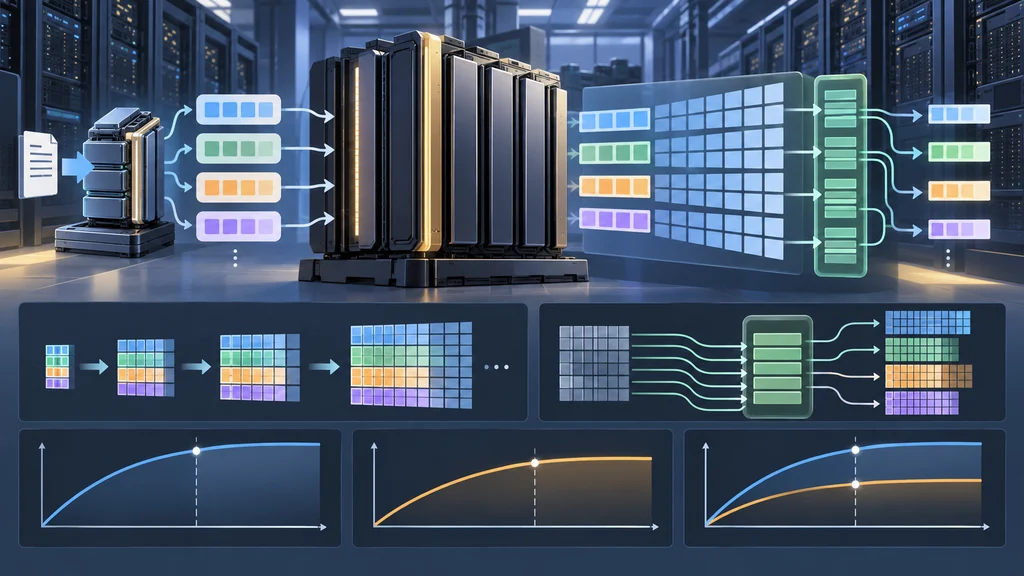
LLMの投機的デコードで先読みするトークン数について、NVIDIAはGPU上の行列演算とAttentionの処理特性に基づく選定指針を示した。候補を増やす効果は、処理の律速条件によって変わる。
候補をまとめて検証する投機的デコード
投機的デコードでは、小さなドラフトモデルが次の候補トークンを複数生成し、大きな対象モデルが一度の処理で並列に検証する。対象モデルは候補を先頭から受け入れ、最初に一致しなかった位置から生成を続ける。
候補トークン数をDとすると、対象モデルの1回の検証で生成されるトークン数は1から1+Dまで変わる。NVIDIAの分析では、この受け入れ数に加え、並列検証にかかる時間とドラフト生成自体の時間が、速度向上を左右する。
候補長が行列演算の処理量を変える
候補を増やすと、対象モデルの線形層における行列積のM次元は、候補なしの場合の1+D倍になる。これにより、小さいバッチでもGPUの計算能力を使う処理領域へ近づく。
NVIDIAが示した代表的な行列積の例では、D=7の場合、D=0の場合の8分の1のバッチサイズで計算律速の領域に達した。この数値は示された行列積の条件での比較であり、LLM全体の速度向上率を表すものではない。
同じKVキャッシュを使うAttentionの検証
先読みしたトークンは、検証時に同じKVキャッシュを再利用する。1つのKVヘッドを共有するクエリヘッド数をGとすると、デコードAttentionの演算密度は候補なしの約2×Gから、候補長Dで約2×G×(1+D)になる。
この関係は、候補長だけでなく、ヘッドの構成もAttentionの処理効率に関わることを示す。Attentionが処理時間を支配する条件では、NVIDIAは現行GPUのカーネルがM次元128で高い利用率に達することから、D=128÷G-1を候補長の指針としている。
処理量の飽和が候補長の上限を決める
NVIDIAが示したAttentionの比較では、G=32の構成はG=8の構成より短い候補長で処理量が飽和した。共有するクエリヘッド数が異なれば、同じ候補長でもGPUの利用率が変わる。
飽和点を超えると、Attentionの実行時間は候補長に応じて増える。一方、1回の検証で得られるトークン数は候補長に比例して増えないため、候補を伸ばし続けるだけでは処理効率を高められない。