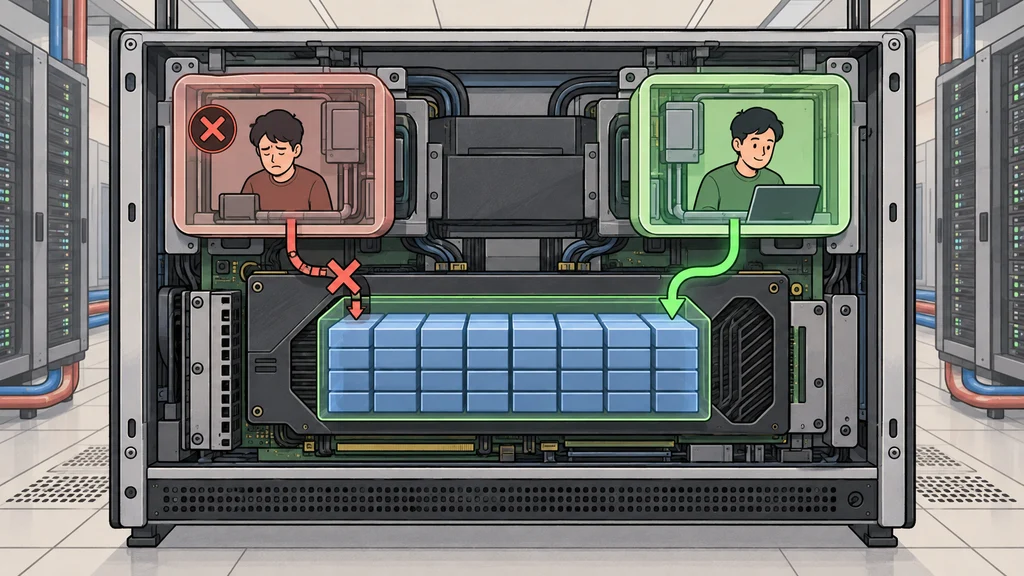
LLM推論エンジンの障害に備え、GPU上のモデル重みを共有する待機エンジンが事前に初期化される。NVIDIAの2ワーカー構成での測定では、1基の停止後に代替ワーカーが稼働するまでの時間が、通常の再起動の283秒から7.3秒に縮まった。
再起動に時間がかかる理由
推論エンジンのプロセスが停止すると、通常はモデル重みをストレージからGPUメモリーへ読み直し、カーネルの準備やCUDAグラフの取得をやり直す。大規模モデルでは、この初期化が処理能力を戻すまでの待ち時間になる。
重みを読み直す必要があるのは、通常の構成ではGPUメモリー上の重みがエンジンのCUDAコンテキストに結び付いているためだ。プロセスが終了するとその領域も解放され、代わりのプロセスは残った重みをそのまま使えない。
モデル重みをエンジンの外で保持する
NVIDIAの推論基盤Dynamoでは、GPU Memory Service(GMS)が推論エンジンとは別のプロセスとして重みの物理GPUメモリーを保持する。エンジンのプロセスが失われても、GMSが保持する重みを代替エンジンが利用できる。
稼働中のエンジンと待機エンジンは、それぞれのCUDAコンテキストから同じ物理ページをマッピングする。GPUの高帯域幅メモリー(HBM)にモデル重みのコピーをもう1つ置かずに、両方のエンジンを同じGPU上に用意できる。
待機エンジンが実行状態を先に整える
重みの共有だけでは、通信器の確立やCUDAグラフの取得にかかる時間は消えない。待機エンジンは障害が起きる前にこれらの初期化とウォームアップを終え、再確保できるメモリー領域を解放して要求を処理せずに待つ。
稼働中のエンジンがプロセス障害で終了しても、GPUとノードが健全なら、待機側がGMSの保持する重みを利用して処理を引き継ぐ。障害後に新しいエンジンを一から起動する経路を避けられる構成だ。
2ワーカー構成で再開時間を比較
NVIDIAはB200ノード上でGLM-5.2を動かす2ワーカー構成を使い、1基を意図的に停止して比較した。2基目が処理を再開するまでの時間は、通常の再起動で283秒、待機エンジン方式で7.3秒だった。
通常の再起動では、残る1基が停止したワーカーの分も含めて全流入要求を処理した。NVIDIAの測定では、その間、最初のトークンが出るまでの時間が増え、利用者ごとのデコード速度が低下した。
切り替えの適用条件と引き継がない状態
この待機エンジン方式は試験提供の機能で、Kubernetes 1.34以降とDynamic Resource Allocation、NVIDIA GPU DRAドライバーなどを前提とする。対象となるのは、GPUとノードが残っている状態で起きたエンジンのプロセス障害だ。
引き継ぐのはGPU上に保持されたモデル重みと事前に準備した待機エンジンであり、処理中の要求やKVキャッシュの状態は保存されない。このため、7.3秒という測定値は代替ワーカーが処理を再開するまでの時間を示す。