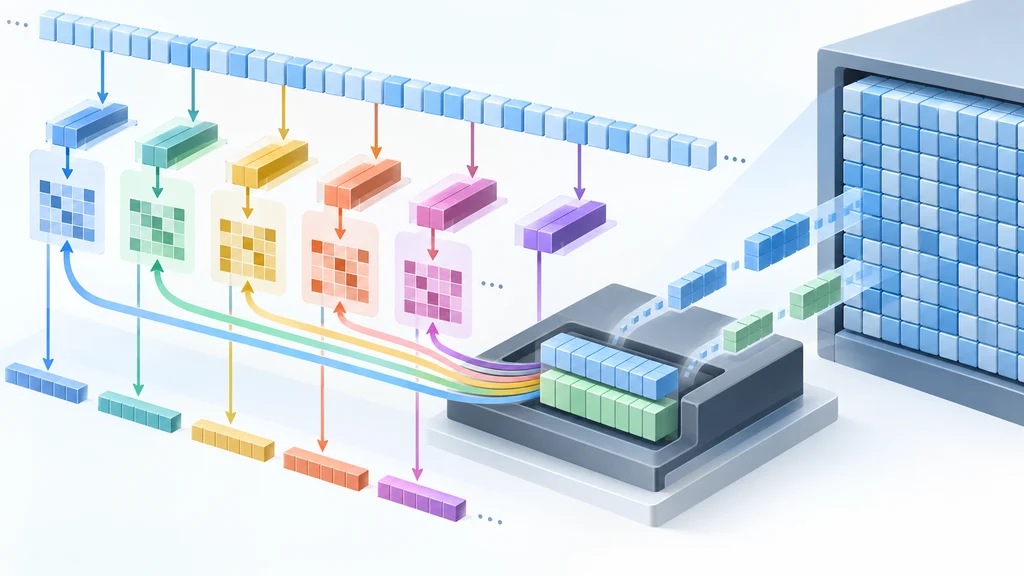
LLMのAttentionでKVヘッドを共有するクエリーヘッド数を増やしても、入力処理時間はほぼ変わらない。NVIDIAの測定では共有数を1から64まで変えた際の差は1%未満で、生成処理では共有によってトークン当たりのKV読み出しを減らせる。
長い入力で増すAttentionの処理割合
長い入力では、LLMの入力処理に占めるAttentionの割合が大きくなる。NVIDIAが示したLLM「DeepSeek-R1」の内訳では、入力長が4Kから128Kトークンに伸びる間に、その割合は18%から85%に上がった。
NVIDIAは、行列演算の形状から導いた式とGPUカーネルの測定を組み合わせ、Attentionの設計が処理時間へ及ぼす影響を調べた。測定ではAttention演算とKVキャッシュの双方にFP8を使用している。
入力処理と生成処理で異なる制約
入力処理はプロンプト全体を並列に扱うため、主に行列演算とsoftmaxの計算量に制約される。投機的デコードを使わず一度に1トークンを生成する処理では、過去の情報を保持するKVキャッシュの読み出しが主な制約になる。
この演算を担うFlashAttentionは、クエリー、キー、値のデータを高帯域メモリーからGPU内のSRAMへ小分けに移し、Attentionの行列全体をメモリー上に作らずに計算する。クエリーとキーの積を求め、逐次的なsoftmaxで重みを計算してから値を集約するまでを、一つの処理にまとめている。
KVヘッドを共有して変わる演算密度
共有の度合いを表すグループサイズGは、一つのKVヘッドを使うクエリーヘッドの数で、クエリーヘッド数をKVヘッド数で割って求める。KVヘッドを共有しないMHAではGが1となり、GQAでは4、8、16など、全クエリーヘッドで一つのKVヘッドを共有するMQAではクエリーヘッド数と同じ値になる。
入力処理では、共有数を増やしても演算密度の変化は小さい。入力長32Kトークンの計算例では、Gを8から16に増やしたときの演算密度の上昇は6%未満だった。
共有数を変えた測定で見えた処理時間の差
NVIDIAの測定では、Gを1から64まで変えても入力処理時間の差は1%未満だった。入力処理が主に計算量に制約されるため、KVヘッドの共有数を大きく変えても、この測定では実行時間はほぼ変わらなかった。
生成処理では、通常8~16のGがGPUの演算タイル幅64または128より小さく、タイル内の並列作業が限られる。Gを増やすとトークン当たりのKV読み出しを減らせるうえ、読み出したデータをより多くのクエリーヘッドで利用できる。