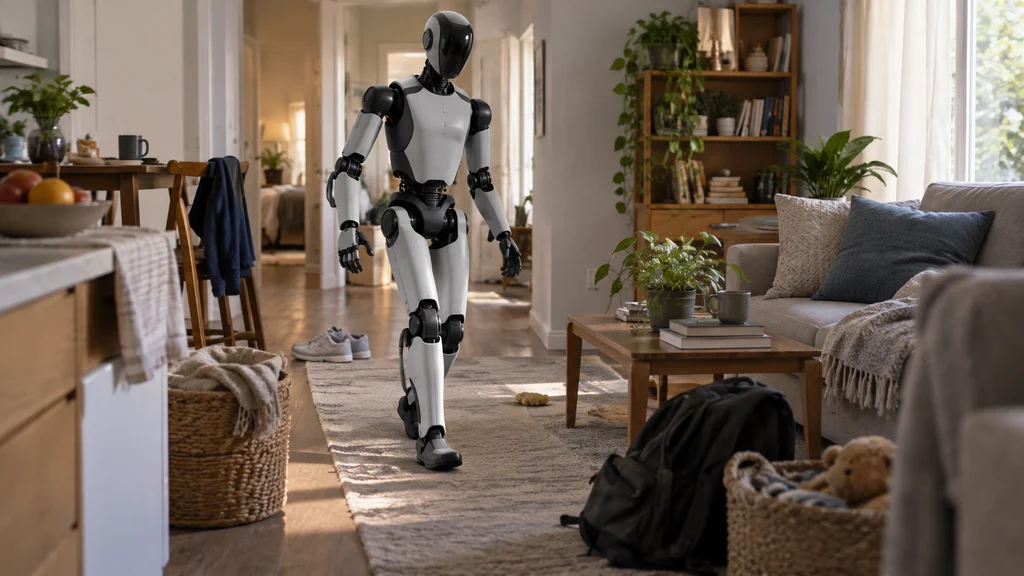
人の視点で撮影した動画だけで移動行動を学習した人型ロボットが、言葉の指示に従って物が入り組んだ住宅内を移動した。Figure AIは、ロボットによる実演データを使わずに、視覚・言語・行動モデルHelixへ人の移動行動を移したとしている。
住宅で撮影した人の行動を学習データにする
Figure AIは、大規模な事前学習データの収集計画Project Go-Bigを進め、Brookfieldの施設でデータ収集を始めている。今回の移動行動の学習には、Brookfieldの住宅で人が行動する様子を一人称視点で撮影した動画を使った。
人型ロボット向け視覚・言語・行動モデルのHelixは、この人の視点の動画だけを使って移動行動を学習した。Figure AIによると、学習にロボットによる実演データは使っていない。
画像と言葉から移動の速度指令を出す
学習した移動行動は、ロボットへの言葉の指示とカメラ画像を受けて動作に変わる。Helixは画像と言語の入力から、平面上の移動に使うSE(2)速度指令までを出力する。
Figure AIによると、モデルは画像を使った閉ループ制御で移動中の動作を生成する。ロボットはこの制御を使い、自然言語の指示に従って物が入り組んだ住宅内を移動したという。
物体操作を中心としたモデルに移動を加える
Helixは従来、洗濯物を畳むことや食器洗い機に物を入れることなど、上半身による物体操作を中心に扱っていた。今回の学習で加わった移動は、指示された場所へ向かうための動作を担う。
単一のネットワークが二種類の動作を指令する
Figure AIによると、現在は単一のHelixネットワークが物体操作と移動の両方の指令を出力する。人の動画から学んだ移動行動が、物体操作を扱うモデルの出力に加わった形だ。