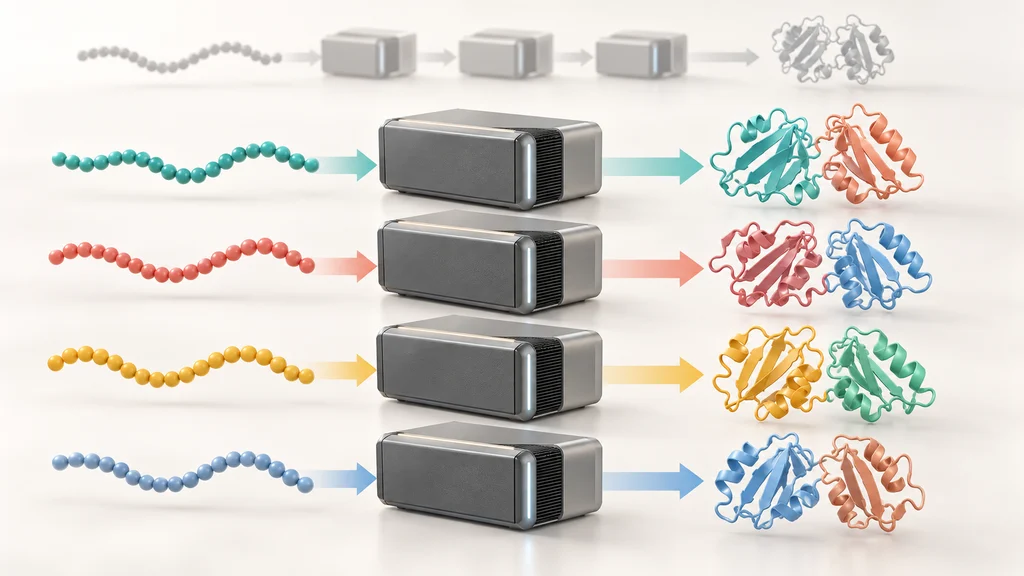
生体分子の構造予測で、モデル内部のGPU演算と多数の入力を流す処理経路を高速化する推論基盤が登場した。NVIDIAの比較では、タンパク質二量体1000件について、GPU時間当たりの予測済み残基数が公開実装の2.90倍となった。
配列入力を構造ファイルへつなぐ5段階の処理
NVIDIAの生体分子構造予測向けPythonライブラリ「BioNeMo Inference Runtime」は、対応モデルをGPU上で実行し、PyTorchのモジュールとして扱える。入力から出力までの経路は、解析、トークン化、特徴量生成、GPU推論、書き出しの5段階で構成される。
タンパク質鎖の入力には、各鎖にA3M形式の多重配列アラインメントが必要だ。推論後の構造はPDBまたはmmCIF形式のファイルとして出力される。
モデル内部の演算と組み込み方法を最適化
一連の予測処理を使う方法に加え、対応モデルや最適化された部品を独自のPyTorchコードへ組み込む方法もある。これにより、既存のコードでモデルを扱う場合にも、対応する部品を利用できる。
モデル実行では、対応するGPU演算に最適化カーネルを適用する。対応モジュールにはCUDA Graphも利用し、モデル内部の処理を高速化する。
独立した予測をGPUごとのモデル複製へ振り分ける
逐次実行方式では、一つの入力を最後の段階まで処理してから次の入力へ進む。個別の予測を確認する際には、この順序で各段階の動作を追える。
多数の独立した入力にはRayを使う方式を用意した。単一ノードの各GPUにモデル全体の複製を置いて別々の入力を並行処理し、CPU側の処理とGPU推論を重ねられる。
1000件の二量体で測ったGPU時間当たりの処理量
NVIDIAは、ヒトのタンパク質二量体1000件を対象に、高速化したBoltz-2構造予測モデルとPyTorchの公開実装を比較した。両者には同じ対象、用意済みの多重配列アラインメント、推論条件、H100 GPU 8基を使った。
この比較で、割り当てられたGPUの稼働1時間当たりに予測を完了した残基数は、高速化したBoltz-2が5万8500、公開実装が2万200となった。NVIDIAの測定では、対象と条件をそろえた場合の処理量は2.90倍だった。