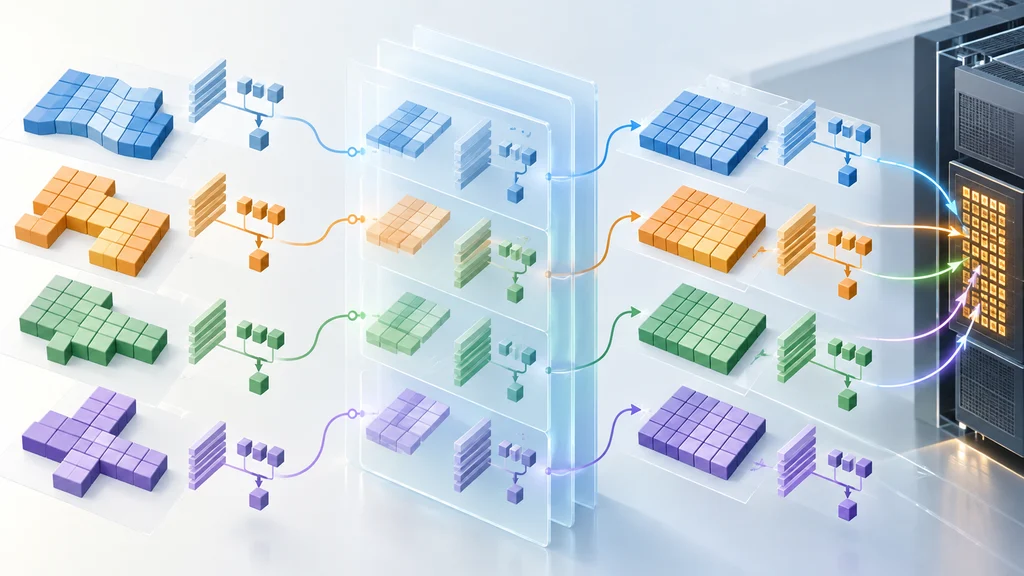
GPUカーネルをPython系の実装からRustへ移すAIエージェント用スキルにより、TileGymの公開演算子24種が移植された。NVIDIAは中間表現の比較を変換工程に組み込み、移植版がcuTile Python版の平均99.5%の性能に達したとしている。
約40のカーネルを段階ごとに変換する
NVIDIAのチームは、GPUカーネル集TileGymにあるcuTile PythonとTriton-TileIRの実装を、cuTile Rustへ変換するAIエージェント用スキルを開発した。このスキルを使い、公開演算子24種すべてを移植した。対象には合計で約40のGPUカーネルが含まれる。
変換は元の実装の解析から始まり、デバイスカーネル、ホスト側とffiのコード、ベンチマークへ進む。各段階で検査プログラムなどが機械的に判定できる結果を出し、次の段階へ進めるかを決める。
共通の中間表現で移植前後を照合する
cuTile Python、Triton-TileIR、cuTile RustはいずれもCUDA Tile IRという中間表現を生成し、同じtileirasコンパイラへ渡す。この共通の出力を使い、変換工程では元のカーネルと移植版のTile IRを機能テストより前に比較する。
比較するのは、メモリー操作の種類、データをまとめて扱うタイルの形状、値を集約するリダクションの構造だ。演算結果を試す前に、カーネルの構造が元の実装に対応しているかを確認できる。
Pythonの暗黙の特殊化をRustの宣言へ移す
cuTile Pythonはカーネルの呼び出し時に、渡された値に応じて処理を暗黙に特殊化する。cuTile Rustでは特殊化する条件をカーネルのシグネチャに明示する必要があり、移植時にはPython側で省略できた条件を書き出す。
Rustのソースは事前にコンパイルされ、タイル形状と要素型がrustcで検査される。GPUバイナリーは初回起動時に具体的なconst genericsの値に合わせてコンパイルされ、以後のためにキャッシュされる。
条件分岐の扱いも変わる。Python側でコンパイル前に除かれる枝もRust側では型検査が必要なため、分岐によってタイルの階数が変わる場合は別々のRustエントリーへ分ける。
同じ演算子APIから呼び出し、性能を比較する
移植したカーネルは、TileGymで選択できるcuTile Rustバックエンドとして組み込まれた。利用者はバックエンドを切り替え、同じ演算子APIからRustのカーネルを呼び出せる。
NVIDIAによると、移植した演算子は平均でcuTile Python版の99.5%の性能に達した。共通の演算子APIで利用できる移植版について、元のPython版を基準に測定した結果である。