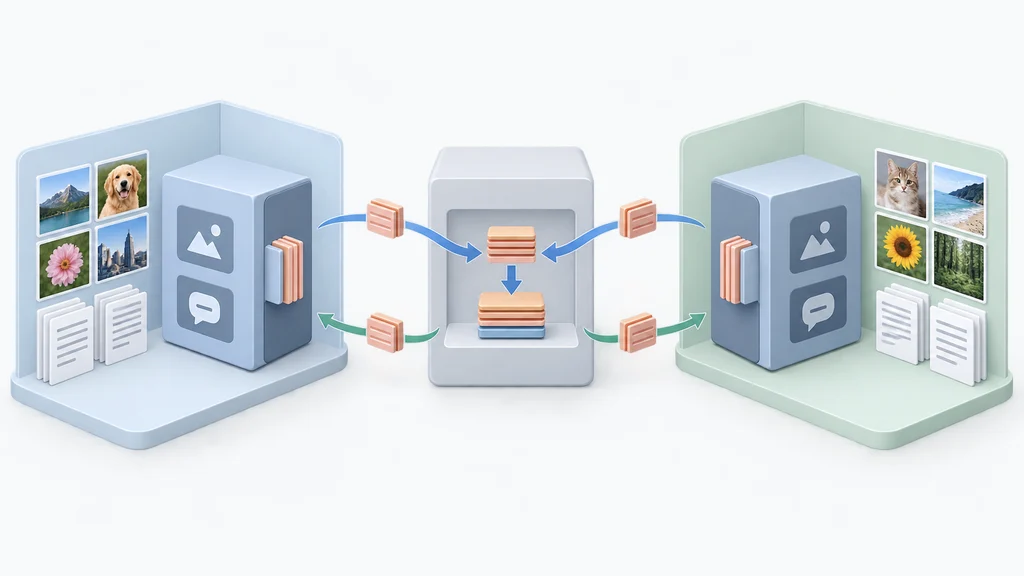
画像と言語を扱うAIの連合学習で、モデル全体ではなく軽量なアダプターだけを共有するFedUMMが、8クライアントの比較で各クライアント・各回の通信量を28.6GBから0.094GBに減らした。学習データは各参加先に置いたまま、サーバーが更新を集約する。
参加先のデータを動かさずに学習ラウンドを進める
NVIDIAの連合学習基盤NVIDIA FLAREでは、サーバーが学習ラウンドを調整し、各クライアントが手元のデータで学習または評価を行う。画像、文章、質問応答の例を一カ所へ集める代わりに、学習によって得た更新をサーバーへ渡す構成だ。
この基盤のFedAvgレシピは、シミュレーションにも、構成済みの複数拠点環境にも適用できる。FedUMMの評価はシミュレーションで行われ、各クライアントが異なるデータ分布を持つ条件も扱う。
固定した基盤モデルにLoRAアダプターだけを学習させる
William & MaryとNVIDIAが開発した連合学習手法FedUMMの研究実験では、画像と言語を扱う基盤モデルBLIP3oを固定し、各クライアントがLoRAアダプターを学習する。LoRAは、基盤モデルの重みをすべて更新する代わりに、追加した少量のパラメーターを学習する手法だ。
各クライアントからサーバーへ送るのは、そのアダプターの更新だけである。サーバーもアダプターの更新だけを集約するため、モデル全体の重みを毎回やり取りする構成に比べ、共有するデータ量を絞れる。
8クライアントで通信量と質問応答の成績を比較
FedUMMの評価には、画像についての質問に答えるVQA v2と、画像生成を評価するGenEvalが使われた。クライアント数は最大16で、参加先ごとのデータ分布の偏りも変えている。
NVIDIAが示した8クライアントの比較では、各クライアント・各ラウンドの通信量は、モデル全体を更新する方式の28.6GBに対し、アダプターだけを更新する方式で0.094GBだった。同じ比較で、VQA v2の成績はモデル全体を集約するFedAvgを0.7ポイント上回った。
別の基準となる集中学習との比較では、公開リポジトリに記載されたVQA v2の成績は集中学習が82.4%、8クライアントでデータ分布の偏りを制御するパラメーターを0.5にしたFedUMMが約80.2%である。比較相手と条件が異なるため、この数値は前段の0.7ポイント差とは分けて読む必要がある。
大きな更新には転送と集約のメモリー対策を用意
アダプターだけを共有する方法とは別に、NVIDIA FLAREは大きなモデル更新を扱う仕組みも備える。大きなオブジェクトはメッセージ内の参照に置き換え、実データを別に転送できるため、制御用メッセージを小さく保てる。
PyTorch向けのFLARE Tensor Downloaderは、要求されたテンソルのチャンクを逐次転送し、モデル配布時に一度に保持するデータを抑える。サーバー側の集約では、NVIDIA FLARE 2.8.0のtensor disk offloadが受信したPyTorch FedAvgの更新を一時的なsafetensorsファイルへ書き出し、必要に応じて読み込む。転送時と集約時に生じるメモリー負荷を、それぞれ別の処理で扱う構成になっている。