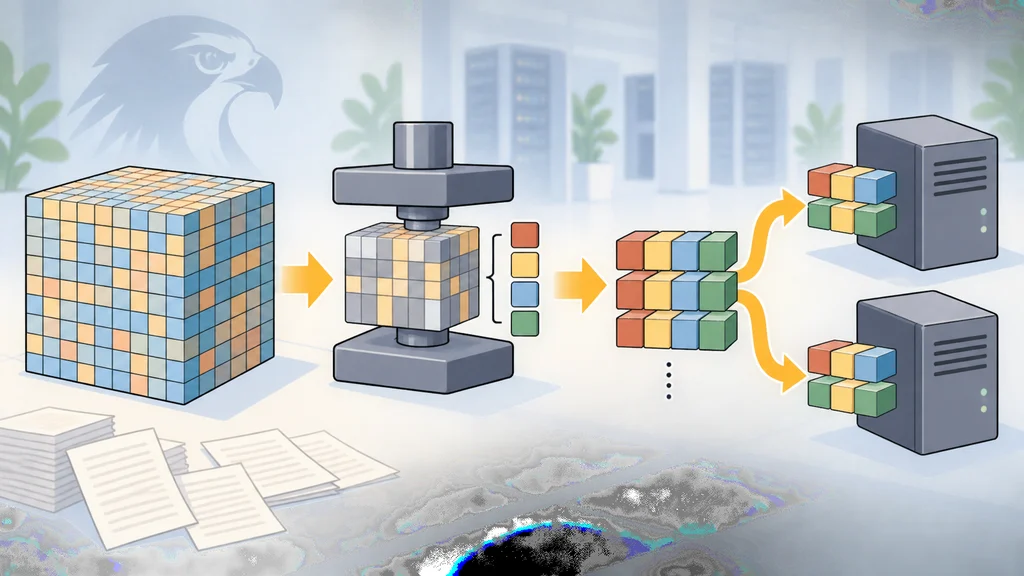
Falcon-40Bをgptqで4ビット量子化したモデル「falcon-40b-gptq」が公開された。Hugging Faceは元モデルとの関係と量子化条件を明示し、推論ソフトウェアで使うための設定を用意した。
Falconの元モデルから量子化版を作成
Hugging Faceが公開した言語モデル「falcon-40b-gptq」は、「tiiuae/falcon-40b」を厳密に複製したうえでgptq量子化を施した派生版だ。モデルの出自を元のFalconに結び付けながら、量子化済みのモデルを別の識別子で提供している。
gptqの量子化条件は4ビットとグループサイズ128
量子化にはWikiText-2を使い、ビット幅を4ビット、グループサイズを128に設定した。gptqはモデルの重みを量子化する手法で、この二つの数値は公開された派生版の量子化条件を特定する。
推論ソフトウェアには2シャードで指定
この量子化版はHugging Faceの推論ソフトウェア「text-generation-inference」での利用を想定している。起動例ではモデルIDに「huggingface/falcon-40b-gptq」を設定し、シャード数を2に指定する。これにより、どの公開モデルを推論処理へ読み込むかが設定上明確になる。
コンテナ起動時にもgptqを明示
Dockerを使う起動例では、text-generation-inferenceのバージョン0.8を指定し、量子化方式として「gptq」を渡す。公開されたモデルIDと量子化方式を組み合わせて、量子化済みの派生版を推論ソフトウェアへ指定する構成だ。