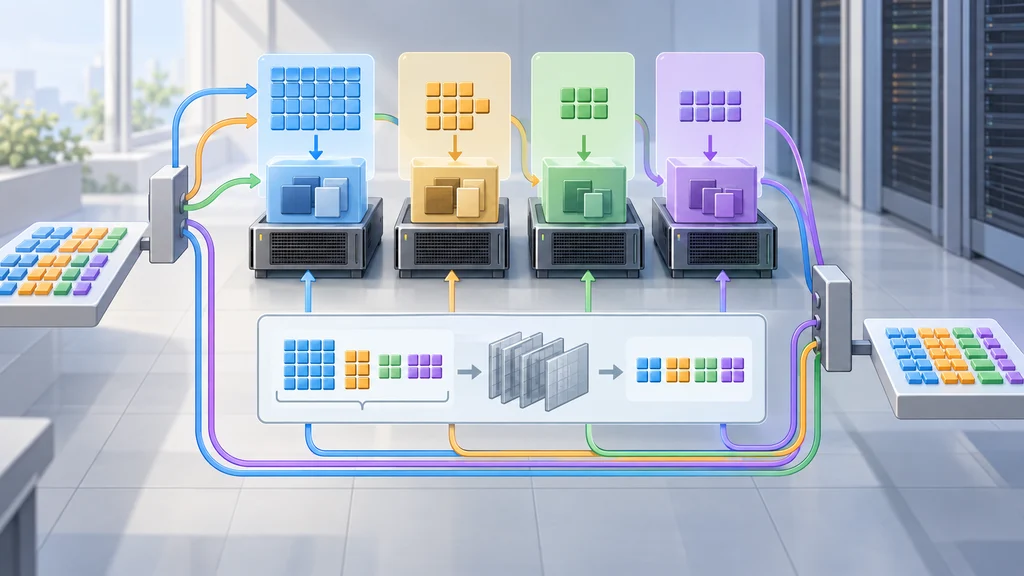
Expertごとに届くトークン数が変わるMoEモデルの学習を、JAX向けのGrouped GEMMなどで高速化した。NVIDIAのDeepSeek-V3測定では、GPU当たりの演算性能が最適化前の10.4倍となった。
Expertへの割り当てが計算量を変える
Mixture of Experts(MoE)では、ルーターがトークンごとに処理を担当するExpertを選ぶ。割り当て数はExpertごとに異なり、学習中にも変わるため、すべてのExpertを同じ大きさの行列として処理しにくい。
Dropless MoEは、割り当てが偏っても選ばれたExpertで全トークンを処理する。Expertの容量を固定する方式では、容量を超えたトークンを破棄するか、固定形状に合わせて余白を埋めることになる。
Grouped GEMMが実トークン数だけを計算する
NVIDIAのTransformer Engineは、Expertごとに長さの異なる入力をGrouped GEMMで扱う。複数のExpertの行列積を一度のカーネル呼び出しにまとめ、それぞれに実際に割り当てられたトークンの領域だけを計算する。
JAX向けの構成には、Expertの行列積に対応するMXFP8のGrouped GEMMと、グループ単位の量子化も含まれる。入力の長さが揃わないMoEの計算を、固定容量に合わせた余白埋めに頼らず進める構成だ。
GPU間の送信と回収もExpert並列処理に組み込む
Expertが複数のGPUに分かれると、ルーターの選択だけでは計算は始まらない。トークンを担当するExpertのGPUへ送り、計算された出力を回収して元のトークン順へ戻す必要がある。
Transformer Engineは、この送信と回収に最適化したExpert並列処理を提供する。Grouped GEMMが各Expert内の行列積を担い、その前後でGPU間のトークン移動を扱う。
DeepSeek-V3の測定でGPU当たり10.4倍
NVIDIAのDeepSeek-V3学習測定では、最適化前のGPU当たりの演算性能は103 TFLOPSだった。この構成では、GPU間通信が累積カーネル時間の84%を占めていた。
JAXとTransformer Engineによる最適化後、GPU当たりの演算性能は1068 TFLOPSとなり、最適化前の10.4倍に達した。結果は、トークン数が揃わないExpertの計算とGPU間の受け渡しを合わせて改善した構成の測定値である。