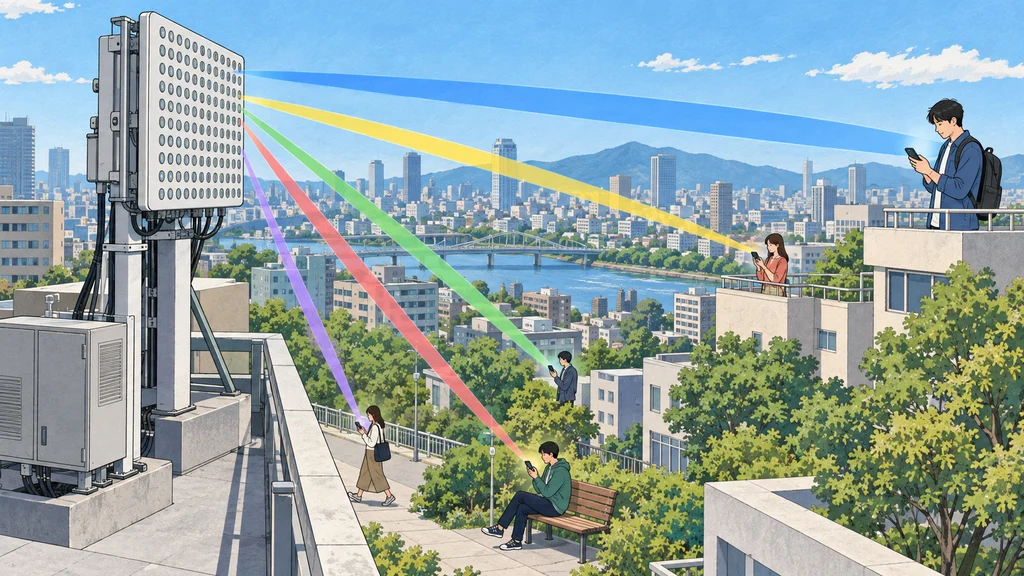
基地局のビーム形成に機械学習を使うと、64T64Rを想定したNVIDIAの分析で、32層のスループットが従来方式の1.62倍になった。計算量も増えるが、GPUで複雑な処理を実行する構成が、その比較の前提となる。
同時通信する利用者の組み合わせをGPUで評価する
複数利用者に同じ時間・周波数資源を割り当てるMU-MIMOでは、どの利用者を組み合わせるかによって干渉と伝送効率が変わる。組み合わせに加え、周波数と空間資源の割り当ても評価するため、候補が増えるほど処理は複雑になる。
NVIDIAは、GPUによって利用者の候補グループを並列に評価できるとしている。この処理で同時通信の対象を選んだ後、各利用者へ電波を向けるビーム形成にも大きな行列演算が必要になる。
チャネル情報からビーム形成の重みを作る
機械学習ベースのビーム形成は、より多くのチャネル情報を使って、送信信号を各利用者へ向けるための重みを生成する。従来の正則化ゼロフォーシング方式より多くの計算を要する一方、利用者間の干渉を考慮した重み付けを詳しく評価できる。
NVIDIAは、64T64RのMU-MIMOで利用者16人にそれぞれ2層を割り当て、各利用者のSNRを0~20dBから無作為に設定して両方式を比較した。この条件の下で、計算量とスループットの差を示している。
計算量の増加と32層でのスループット差
NVIDIAの比較では、1セル当たりの計算量は従来方式の2億7200万FLOPsに対し、AIビーム形成では25億8000万FLOPsだった。より多くの計算を使う方式が、同じ比較条件でどれだけスループットを変えるかが評価点となる。
AIビーム形成のスループットは、16層で従来方式の1.28倍、32層で1.62倍だった。最大1.62倍という値は、この64T64R分析における32層の比較結果を指す。
屋外ではGPU基盤の16層伝送が安定動作
GPUベースのAI-RAN基盤については、SoftBankとNVIDIAが屋外で16層MU-MIMOの安定動作を報告している。無線環境が変化する屋外でも、複数層の同時伝送を継続できたという結果だ。
この屋外試験で報告された周波数利用効率は、従来の4層基準のおよそ3倍だった。比較対象と測定指標は、NVIDIAの64T64Rビーム形成分析における1.62倍のスループットとは異なる。