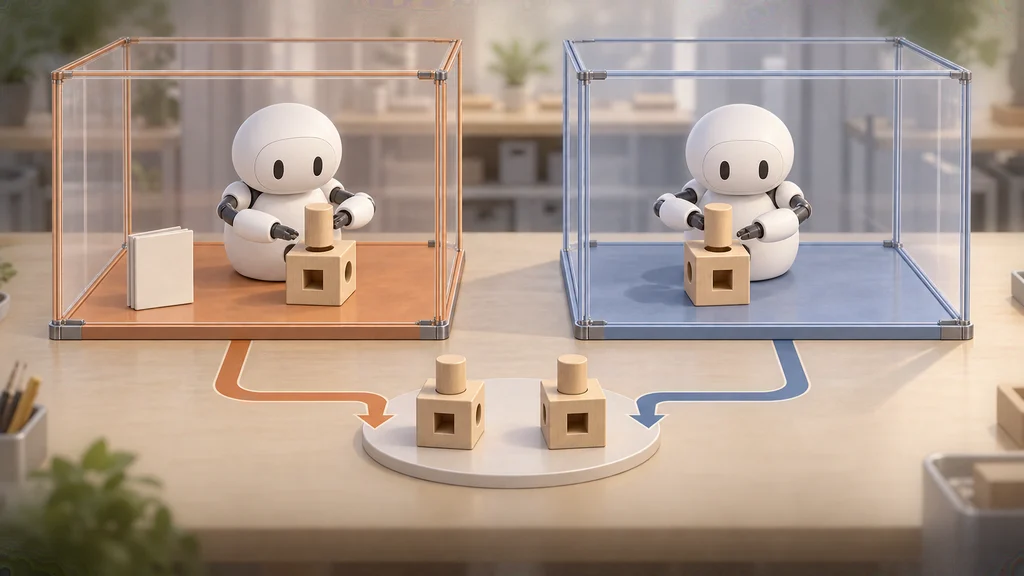
AIエージェント用スキルの効果を、導入有無だけを変えた実タスクの対照実行で測定する仕組みが公開された。NVIDIAは300件超の検証済みスキルを評価し、正答性スコアが平均41点高くなったとしている。
公開前に安全性と案内の重複を調べる
NVIDIAのオープンソース評価ツールSkillEvaluatorは、AIエージェント用スキルを静的検査から実タスクの実行まで三段階で評価する。第1段階では、スキルの記述形式を確かめ、プロンプトインジェクションや情報流出などの危険を検査する。
第2段階では、埋め込み表現の類似度から、スキル内で繰り返される案内や、カタログ内の別のスキルとの対象範囲の重なりを調べる。これらの検査を経たスキルについて、第3段階でエージェントの実行結果を比較する。
スキルの有無だけを変えて課題を実行する
第3段階では、一つの評価課題をスキル導入時と非導入時にそれぞれ実行する。二つの実行は別々の隔離環境で行い、同一のエージェント実行基盤内ではプロンプト、モデル、課題入力、採点基準を揃える。
SkillEvaluatorは評価ケースを、エージェント評価基盤Harborで実行する課題へ変換して結果を集める。導入時のスコアから非導入時のスコアを引いた点数差を「Skill Lift」として示す。
300件超のスキルで正答性の差を測定
NVIDIAは、30を超える製品にわたる300件超の検証済みスキルを、二つのエージェント実行基盤で評価した。スキルを入れない場合の平均スコアは、正答性が100点満点中46点、ユーザーの目標達成と想定された手順の実行を測る有効性が39点だった。
スキル導入時との差は、正答性で平均41点、有効性で平均39点だった。いずれもNVIDIAが評価した課題でのスコア差であり、Skill Liftの単位は%ではなく点である。
個別の結果は試行回数と合わせて読む
公開結果のあるスキルのうち、85%は課題ごとに1回、15%は2回の試行で評価された。エージェントの実行結果には試行ごとの変動があるため、この回数は個々のスキルの点数を読む際の条件になる。