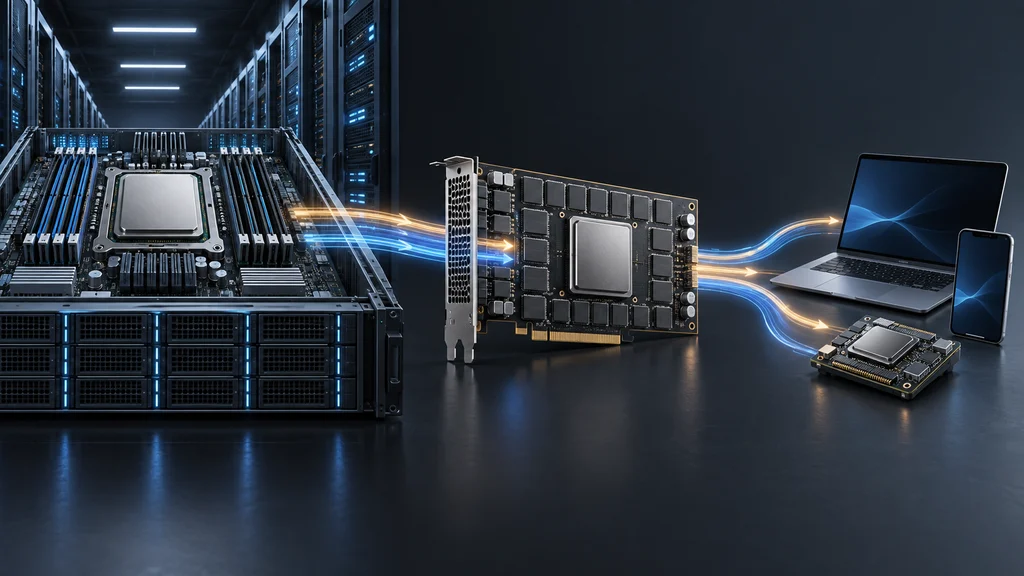
Intelは、データセンターのオーケストレーション、AI推論、端末・エッジ処理を、CPU、GPU、SoCの3アーキテクチャへ割り当てた。
CPU・GPU・SoCに3つの役割を配分
Intelが示した構成は、次世代XeonのDiamond Rapids、データセンター向けGPUのCrescent Island、Intel Core Series 3の開発コード名であるWildcat Lakeで構成される。単一のプロセッサで全範囲を受け持つのではなく、設置場所と処理内容に応じて異なるアーキテクチャを割り当てる。
Diamond Rapidsは企業規模のエージェントAIをオーケストレーションする計算基盤を担い、Crescent IslandはAI推論を処理する。Wildcat Lakeはクライアントとエッジを担当し、データセンターから端末側までを3層でつなぐ設計となる。
Diamond Rapidsは256コアと高速I/Oを集約
サーバーCPUのDiamond Rapidsは、電力効率と性能を強化したIntel 18A-Pプロセスを採用する。新アーキテクチャは変更可能な計算ブロックを統合メモリーファブリックと柔軟なI/Oへ接続し、Foveros Direct 3DとUCIe-SでSoCを構成する。
Intelが示した仕様では、最大256コアと1.28GBのLLCに、12800MT/s対応の16本のメモリーチャネルを組み合わせる。外部接続にはPCIe Gen6とCXL 3.0に対応する128レーンを用意し、計算資源、メモリー、周辺機器を一つのサーバーCPUへ集約する。
Crescent Islandは480GBメモリーを350ワットに収める
推論用GPUのCrescent Islandは、Xe3Pを基礎とする32基のXeコアと256基のXMXエンジンを搭載する。XMXエンジンが行列演算を受け持ち、データセンターで継続的にAI推論を実行する構成である。
メモリーは最大480GBのLPDDR5Xで、大規模なモデル、長いコンテキストウィンドウ、複数のAIエージェントを収容する容量を確保する。これらを350ワットの空冷PCIeカードにまとめ、既存の空冷データセンターへ配置できる形態とした。
Wildcat LakeがUCIeをクライアントSoCへ導入
クライアントおよびエッジ向けSoCのWildcat Lakeは、Intel 18Aプロセスで製造される。CPUコアにXMXアクセラレーション対応の統合Xe3グラフィックスと最大17TOPSのNPUを組み合わせ、端末側で複数の演算器を使い分ける。
このSoCはIntel製プロセッサとして初めてUCIeを採用し、主流価格帯の製品でマルチチップパッケージを構成できる接続方式を導入する。CPUは2基のPerformance-coreと4基のEfficient-coreで、最大LPDDR5X-7467、Wi-Fi 7、Bluetooth 6.0をサポートする。