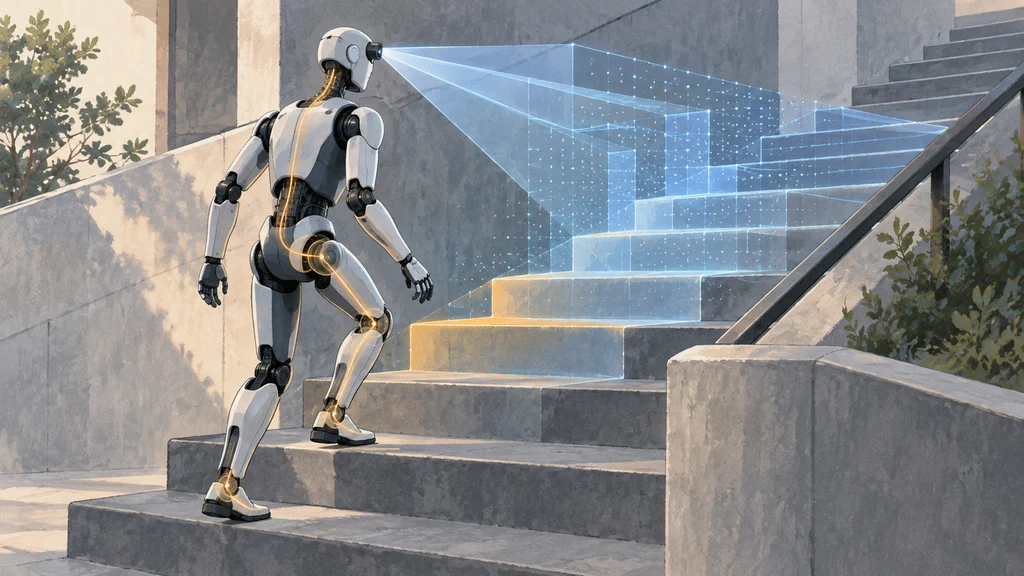
頭部カメラから構築した三次元環境表現を全身制御へ加え、人型ロボットが前方の地形に応じて動けるようになった。Figure AIによると、シミュレーションで訓練した重みを追加調整せず実機へ移し、実環境の階段を歩行したという。
身体状態だけの制御では前方の地形を捉えられない
Figure AIは、人型ロボット向けAIモデルHelixの全身制御モデルSystem 0(S0)に、カメラから得る環境情報を加えた。従来のS0は、関節状態、基部の動き、固有受容情報というロボット自身の状態を入力とし、平地を歩行していた。
身体状態だけを扱う制御ポリシーは、前方の地形を見て次の動作に備えることができない。階段、スロープ、不整地を移動するには、手作業で設定したモード切り替えと操作者の介入が必要だった。
頭部カメラの画像を三次元環境表現へ変換
新しい入力経路では、頭部に搭載したカメラのRGB画像をステレオモデルへ渡す。ステレオモデルは画像からロボット周囲の三次元表現を構築し、これから踏み込む場所の空間情報を生成する。
生成された空間情報は、関節などから得る固有受容状態とともにS0の制御ポリシーへ入力される。制御ポリシーは、身体がどう動いているかだけでなく、周囲の形状も条件として全身の動作を決める。
数千のランダム地形で知覚から動作までを訓練
S0の制御ポリシーは、数千のランダム化された地形を使うシミュレーション内で、強化学習によりエンドツーエンドで訓練された。学習対象には、手続き生成された階段を登る動作も含まれる。
ネットワークは、カメラ由来の空間情報と固有受容状態を入力として受け取り、全身の動作を出力する。シミュレーションで階段を登るよう学習したネットワークと同じ重みが、そのまま実機の制御に使われた。
同じネットワーク重みで実環境の階段を歩行
Figure AIによると、シミュレーションで訓練した同じネットワーク重みにより、実機が実環境の階段を歩行したという。身体状態だけを使う従来の制御から、カメラ由来の環境表現を使って前方の地形に応じる全身制御へ、入力と処理の構成が変わった。
実機への移行では、実環境でのファインチューニング、用途固有のキャリブレーション、操作者による調整を行わなかった。異なる照明条件でも動作しており、シミュレーションで得た制御を同じネットワーク重みのまま実環境へ移した。