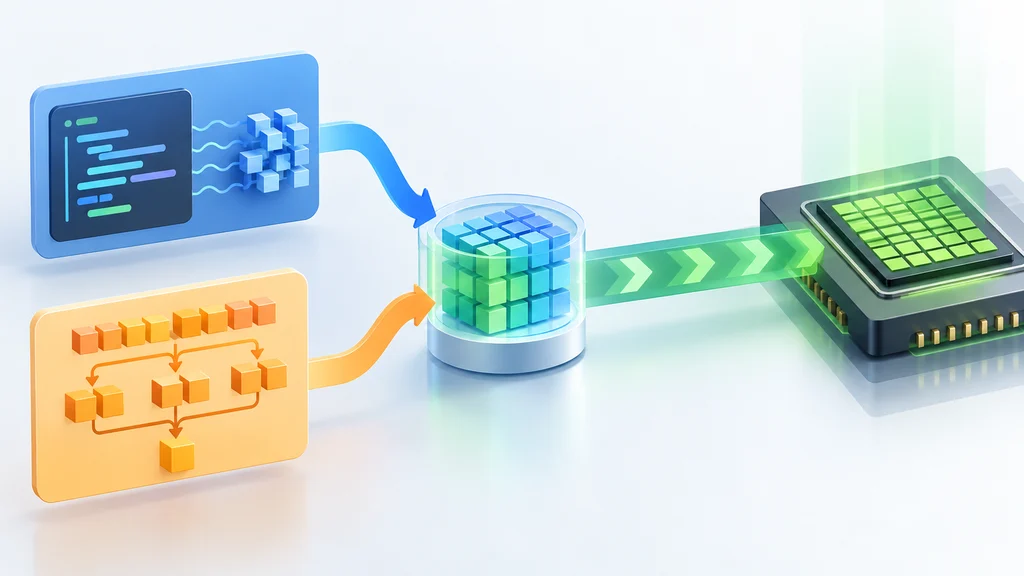
CUDA Python 1.0では、GPUのバッファーやストリームをPython向けライブラリで共有するための共通基盤と、公開APIの変更規則が整った。ライブラリごとに異なっていたCUDAへの接続を、共通のオブジェクトへ寄せる。
独立したライブラリに共通のAPI変更規則
NVIDIAはCUDA 13.3とともに、PythonからCUDAを利用するライブラリ群の節目としてCUDA Python 1.0を公開した。各ライブラリは独立したバージョン番号を持ち、「1.0」は一つのパッケージに付く番号ではなく、ライブラリ群に適用する安定性規則の節目を指す。
公開APIの破壊的変更はメジャーリリースに限られる。削除予定のAPIは、代替手段を示して先にマイナーリリースで非推奨とするため、利用者は変更の時期と移行先を確認できる。
cuda.coreがGPUのバッファーとストリームを共通化
CUDAの基本操作を担うcuda.core 1.0.0は、デバイス、ストリーム、バッファーをPythonのオブジェクトとして提供する。ライブラリがこれらを共通して扱うことで、GPU上のデータと実行順序を別々の接続層へ置き換えずに受け渡せる。
NVIDIAによると、Numbaで記述したカーネルとcuda.computeの呼び出しは、同じGPUバッファーを同じストリーム上で扱えるという。cuda.coreには、GPUのストリーミングマルチプロセッサーを分割するgreen contextsも含まれる。
共通のGPU資源を並列アルゴリズムへ渡す
並列アルゴリズム向けのcuda.compute 1.0.0は、CCCLが提供するsort、scan、reduceなどをPythonから呼び出せるようにする。カーネルで扱うバッファーをアルゴリズムの呼び出しにも渡せることが、共通基盤の具体的な利用経路になる。
NVIDIAの説明では、自社のCUDA関連ライブラリもcuda.coreを基盤とし、バッファー、デバイス、ストリームを共通して扱う。共通オブジェクトは、個々の機能を呼び出す際の土台にもなっている。
低水準APIと実行環境の探索も分担
CUDAのC APIへ直接アクセスする用途には、低水準のPythonバインディングであるcuda.bindings 13.3.0を用意した。一方、cuda-pathfinderは実行環境にインストールされたCUDAコンポーネントを探し、利用するコンポーネントの所在を特定する。
数値計算向けのnvmath-python 1.0は、NVIDIAの数値計算ライブラリをPythonから利用するためのインターフェースを提供する。基本操作、並列アルゴリズム、低水準API、数値計算を担当するライブラリがそれぞれ独立した版で提供される構成だ。